Introduccion al reconocimiento de entidades nombradas con Transformers
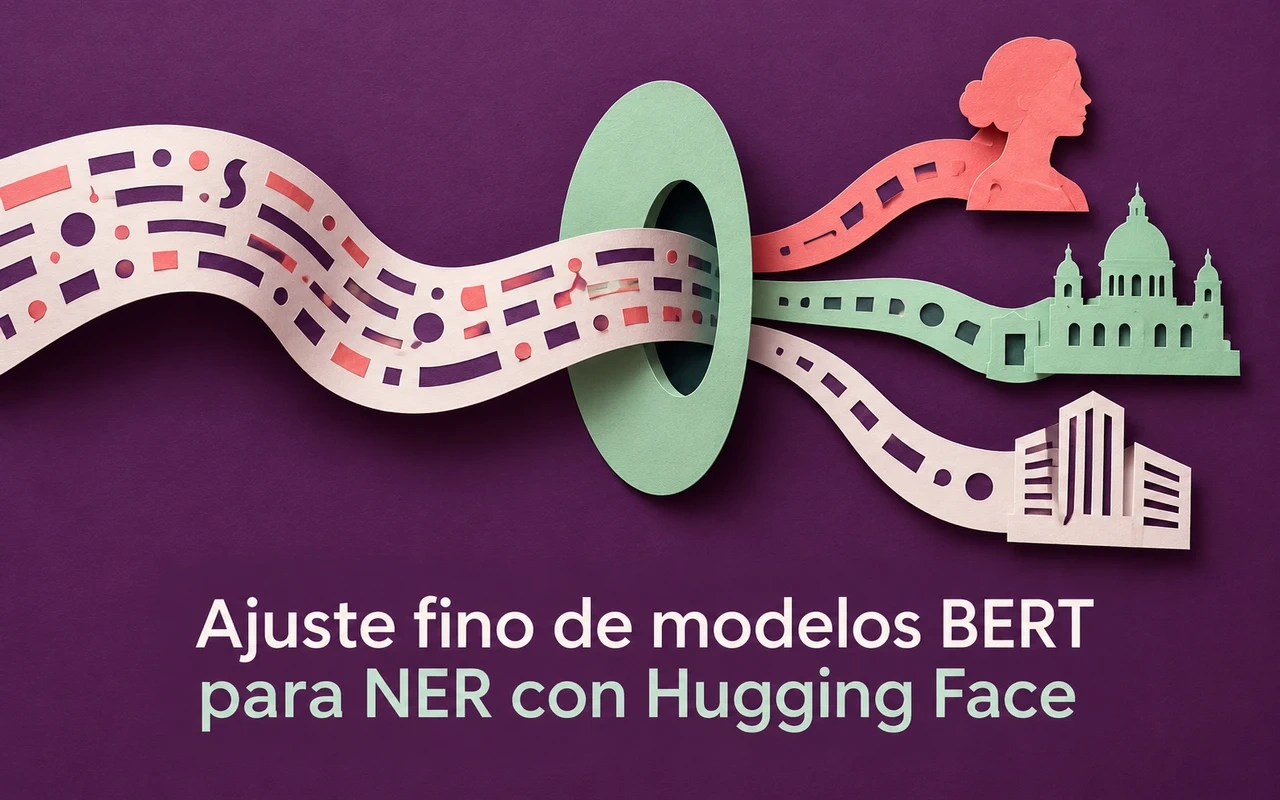
El procesamiento de lenguaje natural ha evolucionado de manera significativa gracias a las arquitecturas basadas en Transformers. Una de las tareas fundamentales dentro de este campo es el reconocimiento de entidades nombradas, que consiste en identificar y clasificar fragmentos de texto que corresponden a personas, organizaciones, ubicaciones u otros tipos de entidades especificas. Esta capacidad resulta esencial en aplicaciones de extraccion de informacion, analisis de documentos, sistemas de busqueda y procesamiento de datos no estructurados.
Los modelos de lenguaje preentrenados, en particular las variantes de BERT, ofrecen una base solida para abordar esta tarea mediante el ajuste fino. La biblioteca Transformers de Hugging Face proporciona las herramientas necesarias para cargar datasets, tokenizar texto, alinear etiquetas y entrenar modelos de clasificacion de tokens de forma eficiente. En el contexto actual de 2026, estos flujos de trabajo siguen siendo una referencia para equipos que requieren control total sobre el entrenamiento y la inferencia local, aunque coexisten con enfoques de zero-shot y modelos generativos de mayor escala.
Este articulo detalla el proceso completo de ajuste fino de un modelo BERT multilingue para la tarea de NER. Se cubren la seleccion del dataset, el preprocesamiento necesario debido a la tokenizacion de subpalabras, la configuracion del entrenamiento con la API Trainer, el calculo de metricas y las consideraciones para compartir el modelo resultante. El enfoque se mantiene practico y orientado a desarrolladores que trabajan con Python y entornos de notebook o scripts de entrenamiento.
Conceptos fundamentales de tokenizacion y arquitectura BERT
Antes de abordar el ajuste fino es necesario comprender como los modelos Transformers representan el texto. La tokenizacion convierte secuencias de palabras en unidades mas pequenas que el modelo puede procesar. Existen varias estrategias: tokenizacion por caracteres, por palabras completas y por subpalabras. La tokenizacion de subpalabras, utilizada por BERT mediante el algoritmo WordPiece, resulta especialmente util porque permite representar palabras poco frecuentes como combinaciones de unidades mas comunes.
Por ejemplo, una palabra rara puede dividirse en un prefijo conocido y un sufijo marcado con un simbolo especial. Esta division obliga a ajustar las etiquetas de NER durante el preprocesamiento, ya que una entidad original puede corresponder a varios tokens. El modelo BERT, basado en la arquitectura Transformer con mecanismo de autoatencion, aprende representaciones contextuales de cada token. Durante el preentrenamiento, el modelo observa grandes corpus y desarrolla la capacidad de capturar relaciones entre palabras dentro de una secuencia.
En el caso de modelos multilingues, el vocabulario y el preentrenamiento cubren multiples idiomas, lo que facilita el ajuste fino en lenguas con menos recursos de datos etiquetados. La version cased de BERT preserva la informacion de mayusculas y minusculas, lo cual resulta relevante para idiomas donde la capitalizacion aporta informacion util para la identificacion de entidades. La version uncased puede introducir normalizaciones que alteran la representacion de ciertas palabras, por lo que la eleccion de la variante cased suele ser preferible para tareas de NER.
Seleccion y carga del dataset de entrenamiento
El dataset WikiANN proporciona anotaciones de entidades nombradas en multiples idiomas. Cada oracion se presenta como una lista de tokens junto con etiquetas en formato BIO (Begin, Inside, Outside) que indican si un token inicia una entidad, forma parte de ella o no pertenece a ninguna. Las categorias tipicas incluyen persona (PER), organizacion (ORG) y ubicacion (LOC).
La carga del dataset se realiza de manera sencilla a traves de la biblioteca datasets de Hugging Face. El codigo siguiente instala las dependencias principales y carga la version correspondiente al bengali como ejemplo de idioma no ingles.
!pip install datasets tokenizers transformers
from datasets import load_dataset

dataset = load_dataset("wikiann", "bn")
label_names = dataset["train"].features["ner_tags"].feature.names
print(label_names)
El objeto resultante contiene divisiones de entrenamiento, validacion y prueba. Inspeccionar las etiquetas permite confirmar que el esquema de anotacion es coherente. En proyectos reales de 2026 es habitual combinar este tipo de datasets publicos con datos de dominio especifico cuando se dispone de ellos, o utilizar tecnicas de aumento de datos para mejorar la cobertura de entidades poco frecuentes.
Preprocesamiento y alineacion de etiquetas con tokenizacion de subpalabras
La tokenizacion de subpalabras introduce un desafio particular en NER: las etiquetas originales estan asociadas a palabras completas, pero el modelo opera sobre tokens que pueden ser fragmentos de esas palabras. Por tanto, es necesario expandir las etiquetas para que cada subtoken reciba la etiqueta correspondiente a la palabra original. Los tokens especiales de inicio y fin de secuencia reciben la etiqueta especial -100, que el calculo de perdida ignora durante el entrenamiento.
El siguiente fragmento de codigo carga el tokenizador del modelo bert-base-multilingual-cased y define una funcion que realiza la codificacion por lotes y la alineacion de etiquetas mediante los identificadores de palabra (word_ids).
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("bert-base-multilingual-cased")

def tokenize_adjust_labels(examples):
    tokenized = tokenizer.batch_encode_plus(
        examples["tokens"], is_split_into_words=True, truncation=True
    )
    all_labels = []
    for i, word_ids in enumerate(tokenized.word_ids(batch_index=idx) for idx in range(len(examples["tokens"]))):
        # Logica de alineacion simplificada para ilustracion
        labels = []
        previous_word_idx = None
        for word_idx in word_ids:
            if word_idx is None:
                labels.append(-100)
            elif word_idx != previous_word_idx:
                labels.append(examples["ner_tags"][i][word_idx])
            else:
                labels.append(examples["ner_tags"][i][word_idx])
            previous_word_idx = word_idx
        all_labels.append(labels)
    tokenized["labels"] = all_labels
    return tokenized

tokenized_dataset = dataset.map(tokenize_adjust_labels, batched=True)
Despues de la tokenizacion, las secuencias tienen longitudes variables. La clase DataCollatorForTokenClassification se encarga de rellenar (padding) los lotes de forma dinamica durante el entrenamiento, asegurando que todos los ejemplos de un lote tengan la misma longitud sin desperdiciar memoria de manera excesiva.
from transformers import DataCollatorForTokenClassification

data_collator = DataCollatorForTokenClassification(tokenizer=tokenizer)
Este enfoque de preprocesamiento es estandar en la comunidad y se mantiene vigente en las versiones recientes de la biblioteca Transformers. La correcta alineacion de etiquetas es uno de los factores que mas influye en la calidad final del modelo de NER.
Configuracion del entrenamiento con la API Trainer
La API Trainer de Hugging Face abstrae el bucle de entrenamiento y proporciona integracion con herramientas de seguimiento de experimentos. Para NER se utiliza el modelo AutoModelForTokenClassification, que anade una capa de clasificacion sobre las representaciones contextuales del modelo base. El numero de etiquetas se determina a partir del esquema del dataset.
Se definen los argumentos de entrenamiento, que incluyen la tasa de aprendizaje, el tamano de lote, el numero de epocas y la estrategia de evaluacion. En configuraciones modernas es comun habilitar el registro de metricas a intervalos regulares y utilizar precision mixta cuando se dispone de GPU compatible.
from transformers import AutoModelForTokenClassification, TrainingArguments, Trainer
import numpy as np
from datasets import load_metric

metric = load_metric("seqeval")

def compute_metrics(eval_pred):
    predictions, labels = eval_pred
    predictions = np.argmax(predictions, axis=2)
    true_predictions = [
        [label_names[p] for (p, l) in zip(pred, lab) if l != -100]
        for pred, lab in zip(predictions, labels)
    ]
    true_labels = [
        [label_names[l] for (p, l) in zip(pred, lab) if l != -100]
        for pred, lab in zip(predictions, labels)
    ]
    results = metric.compute(predictions=true_predictions, references=true_labels)
    return {
        "precision": results["overall_precision"],
        "recall": results["overall_recall"],
        "f1": results["overall_f1"],
        "accuracy": results["overall_accuracy"],
    }

model = AutoModelForTokenClassification.from_pretrained(
    "bert-base-multilingual-cased", num_labels=len(label_names)
)

training_args = TrainingArguments(
    output_dir="./ner-output",
    evaluation_strategy="epoch",
    learning_rate=2e-5,
    per_device_train_batch_size=16,
    per_device_eval_batch_size=16,
    num_train_epochs=3,
    weight_decay=0.01,
    logging_steps=100,
)

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_dataset["train"],
    eval_dataset=tokenized_dataset["validation"],
    data_collator=data_collator,
    tokenizer=tokenizer,
    compute_metrics=compute_metrics,
)

trainer.train()
La metrica seqeval evalua el rendimiento a nivel de entidad completa, no solo de tokens individuales. Esto es importante porque una prediccion parcial de una entidad se considera incorrecta. Los resultados tipicos en datasets como WikiANN dependen del idioma y de la cantidad de datos, pero un ajuste fino cuidadoso suele superar ampliamente a modelos que no han sido adaptados al dominio.
Seguimiento de experimentos y optimizacion de hiperparametros
El seguimiento de experimentos permite comparar diferentes configuraciones de tasa de aprendizaje, numero de epocas o tamano de lote. Plataformas de MLOps registran automaticamente las metricas de perdida y las puntuaciones F1 durante el entrenamiento. Esta visibilidad facilita identificar si el modelo esta sobreajustando o si una configuracion particular converge mas rapido.
En la practica de 2026, muchos equipos integran el registro con servicios en la nube o herramientas locales. La API Trainer admite el parametro report_to para enviar metricas a estos servicios. Ademas, es recomendable guardar checkpoints intermedios para poder retomar el entrenamiento en caso de interrupciones, algo especialmente util cuando se trabaja con recursos de computacion compartidos o con limites de tiempo de sesion.
La seleccion de hiperparametros suele comenzar con valores recomendados en la literatura (tasa de aprendizaje alrededor de 2e-5 o 5e-5 para BERT) y ajustarse segun el comportamiento observado en el conjunto de validacion. Un numero reducido de epocas (entre 3 y 5) suele ser suficiente para el ajuste fino, ya que el modelo base ya contiene representaciones utiles.
Evaluacion del modelo y analisis de resultados
Una vez finalizado el entrenamiento, se evalua el modelo en el conjunto de prueba para obtener una estimacion no sesgada del rendimiento. La funcion compute_metrics ya definida se puede reutilizar. Ademas de las metricas globales de precision, recall y F1, resulta util examinar el rendimiento por tipo de entidad. Algunas categorias, como organizaciones o entidades raras, suelen presentar mayor dificultad.
El codigo de evaluacion sobre el conjunto de prueba se puede ejecutar de la siguiente manera:
test_results = trainer.evaluate(tokenized_dataset["test"])
print(test_results)
En entornos de produccion es habitual complementar estas metricas automaticas con una revision manual de predicciones sobre ejemplos representativos del dominio. Esto ayuda a detectar sesgos o errores sistematicos que las metricas agregadas pueden ocultar. Por ejemplo, el modelo puede confundir ciertos nombres de lugares con organizaciones si el contexto de entrenamiento no fue suficientemente diverso.
Inferencia con el modelo ajustado y uso del pipeline
Despues del entrenamiento, el modelo se puede utilizar para inferencia mediante la clase pipeline de Transformers. Esta interfaz simplifica la tokenizacion, la prediccion y la agregacion de subtokens en entidades completas. La estrategia de agregacion “simple” o “average” agrupa los tokens consecutivos que pertenecen a la misma entidad.
from transformers import pipeline

ner_pipeline = pipeline(
    "token-classification",
    model=model,
    tokenizer=tokenizer,
    aggregation_strategy="simple",
)

text = "Gandalf visito la Comarca la semana pasada."
entities = ner_pipeline(text)
for entity in entities:
    print(entity)
La salida incluye el texto de la entidad, el tipo de etiqueta, la puntuacion de confianza y las posiciones de inicio y fin en el texto original. Esta informacion facilita la integracion en aplicaciones posteriores, como la extraccion de relaciones o la indexacion de documentos. Para textos largos que superan la longitud maxima del modelo, se pueden aplicar estrategias de ventana deslizante o truncamiento con solapamiento.
En 2026, ademas de los modelos BERT clasicos, existen alternativas como GLiNER que permiten reconocer entidades definidas en el momento de la inferencia sin necesidad de reentrenamiento completo. Sin embargo, cuando se dispone de datos etiquetados representativos del dominio, el ajuste fino de un modelo de clasificacion de tokens sigue ofreciendo un equilibrio favorable entre precision y eficiencia de inferencia.
Compartir el modelo y documentacion mediante model card
Una vez que el modelo alcanza un rendimiento satisfactorio, se puede publicar en el Hub de Hugging Face para facilitar su reutilizacion. El proceso implica autenticarse, crear un repositorio y subir los archivos del modelo, el tokenizador y la configuracion. La documentacion se realiza a traves de un model card en formato Markdown con metadatos YAML que describen el idioma, el dataset utilizado y ejemplos de uso.
Los metadatos permiten configurar el widget de inferencia del Hub para que muestre ejemplos en el idioma correcto. Incluir informacion sobre las limitaciones del modelo, el rendimiento observado y las condiciones de entrenamiento ayuda a otros usuarios a decidir si el modelo es adecuado para sus casos de uso. Esta practica de documentacion transparente se ha consolidado como estandar en la comunidad de modelos abiertos.
Consideraciones de produccion y alternativas actuales
El despliegue de un modelo de NER ajustado requiere considerar el rendimiento de inferencia, el consumo de memoria y la necesidad de actualizaciones periodicas. Los modelos BERT base ofrecen un buen equilibrio, aunque variantes destiladas o cuantizadas pueden reducir la latencia en entornos con restricciones de recursos. La integracion con frameworks de serving como TorchServe o servicios de inferencia gestionados simplifica la puesta en produccion.
Comparado con enfoques basados en modelos generativos de gran escala, el ajuste fino de clasificadores de tokens suele ser mas eficiente en costo y latencia cuando las categorias de entidades son conocidas y estables. Los modelos generativos destacan en escenarios de zero-shot o cuando el esquema de entidades cambia con frecuencia, pero su costo por inferencia es significativamente mayor. La eleccion depende del volumen de datos, el presupuesto de computacion y los requisitos de precision del proyecto.
En el panorama de 2026, la combinacion de modelos preentrenados multilingues con tecnicas de ajuste fino eficiente (como LoRA en algunos casos) permite adaptar sistemas de NER a nuevos dominios con cantidades moderadas de datos etiquetados. Mantener un pipeline reproducible de preprocesamiento, entrenamiento y evaluacion resulta fundamental para iterar sobre mejoras del modelo.
Conclusiones
El ajuste fino de modelos BERT para reconocimiento de entidades nombradas mediante la biblioteca Transformers de Hugging Face constituye un flujo de trabajo maduro y bien documentado. El proceso abarca la carga de datasets anotados, la alineacion de etiquetas debido a la tokenizacion de subpalabras, el entrenamiento con la API Trainer y la evaluacion con metricas a nivel de entidad. La correcta gestion de estos pasos permite obtener modelos especializados que superan a las versiones genericas en dominios concretos.
Las practicas descritas se mantienen relevantes en 2026, complementadas por herramientas de seguimiento de experimentos y opciones de publicacion en el Hub de modelos. Aunque han surgido alternativas basadas en modelos generativos y enfoques zero-shot, el ajuste fino de clasificadores de tokens sigue siendo una opcion eficiente cuando se dispone de datos etiquetados y se requiere control sobre el rendimiento y el costo de inferencia. Dominar este flujo proporciona una base solida para construir sistemas de extraccion de informacion adaptados a necesidades especificas.