Un meme que sigue poniendo a prueba a las máquinas
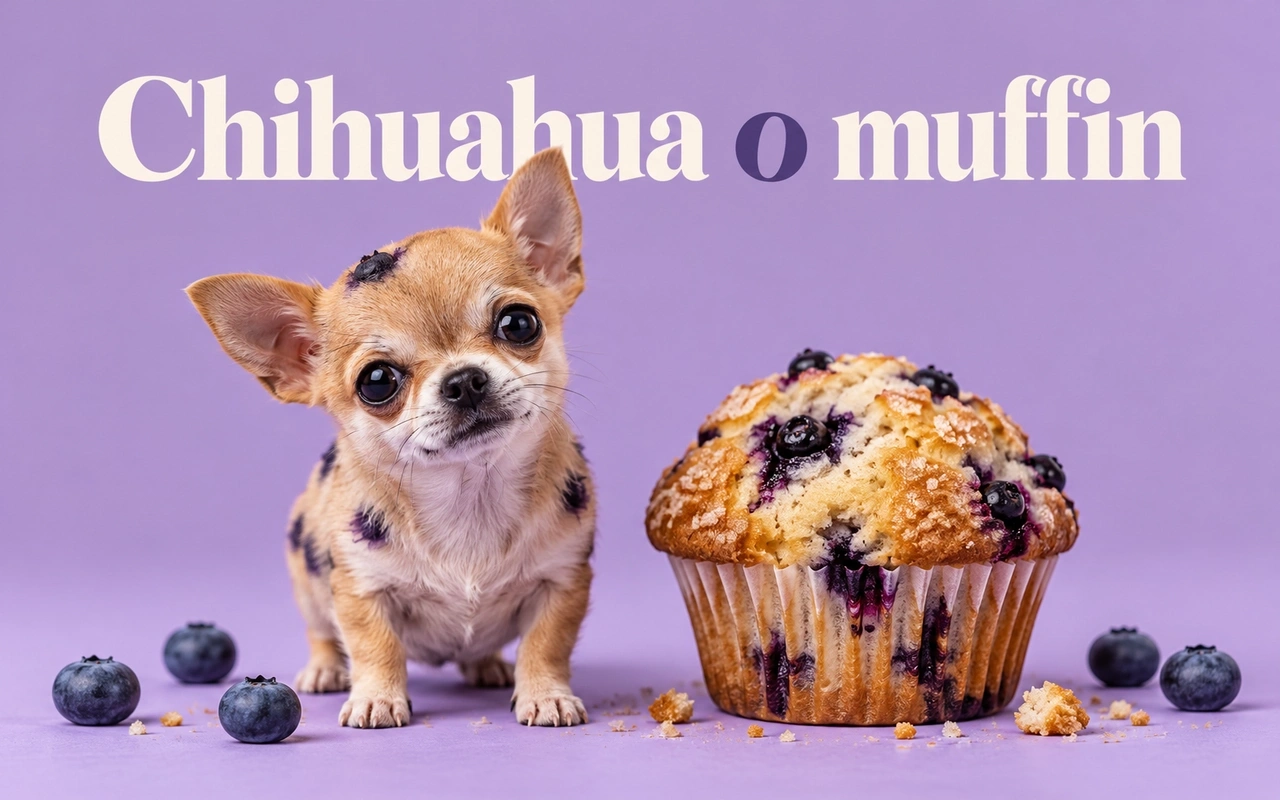
Hace años circuló por internet una cuadrícula de fotos que mezclaba caras de chihuahuas con magdalenas de arándanos. A primera vista, la tarea parece trivial: cualquier niño distingue un perro de un pan dulce. Sin embargo, cuando se colocan uno junto al otro, dos ojos oscuros y un hocico se parecen sorprendentemente a tres arándanos sobre una superficie dorada. El meme se convirtió en un pequeño experimento informal para medir qué tan bien “ven” los sistemas de visión artificial.
Lo interesante es que la prueba sigue siendo útil hoy, aunque la tecnología haya cambiado de forma radical. Ya no solo existen APIs de etiquetado tradicionales; también hay modelos multimodales capaces de describir una imagen en lenguaje natural y modelos abiertos que clasifican imágenes en categorías que nunca vieron durante su entrenamiento. La pregunta práctica para un equipo de desarrollo es la misma de siempre: ¿qué servicio elijo para mi aplicación y cómo lo compruebo con mis propios datos?
En esta guía aprenderás a comparar APIs de visión artificial de forma rigurosa. Construirás en Python un banco de pruebas que envía las mismas imágenes a Google Cloud Vision, Amazon Rekognition, Azure AI Vision, un modelo multimodal de lenguaje y un modelo abierto ejecutado en local. Después normalizarás los resultados, calcularás métricas, revisarás costes y privacidad, y verás cuándo conviene entrenar un modelo propio con PyTorch.
De los perceptrones a los modelos multimodales
Para entender por qué un chihuahua puede confundirse con una magdalena conviene repasar cómo ha evolucionado la visión por computadora.
El punto de partida suele situarse a finales de los años cincuenta, con el perceptrón: una neurona artificial que aprendía a separar dos clases trazando una frontera lineal. Su limitación era evidente, porque la mayoría de problemas reales no se separan con una línea recta. En los años ochenta llegaron los perceptrones multicapa y el algoritmo de retropropagación, que permitieron entrenar redes con capas ocultas capaces de modelar relaciones no lineales.
El gran salto para las imágenes vino de las redes neuronales convolucionales, popularizadas a finales de los noventa para reconocer dígitos manuscritos. En lugar de conectar cada píxel con cada neurona, aplican filtros pequeños que recorren la imagen y detectan bordes, texturas y formas, y luego combinan esas detecciones en patrones cada vez más abstractos. Con la llegada de grandes conjuntos de datos etiquetados como ImageNet y de GPU asequibles, arquitecturas como AlexNet, VGG, Inception y ResNet redujeron drásticamente los errores de clasificación en la década de 2010.
Después llegaron los Vision Transformers, que dividen la imagen en parches y los procesan con mecanismos de atención, y modelos como CLIP, entrenados con cientos de millones de pares imagen-texto. Estos modelos aprendieron a relacionar imágenes con descripciones en lenguaje natural, lo que abrió la puerta a la clasificación sin entrenamiento específico. Hoy, los modelos multimodales de lenguaje combinan un codificador visual con un modelo de lenguaje grande y pueden razonar sobre lo que ven.
Esta evolución explica el comportamiento que verás en las pruebas. Un clasificador entrenado sobre un catálogo fijo de etiquetas responde con la categoría más cercana que conoce. Un modelo multimodal, en cambio, puede describir la escena, admitir ambigüedad o detectar que una imagen es un collage.
Qué ofrecen hoy los servicios de visión
Los proveedores de nube exponen funciones similares, aunque con nombres y matices distintos. Las capacidades más habituales son:
- Detección de etiquetas: devuelve una lista de conceptos presentes en la imagen con un nivel de confianza.
- Detección de objetos: además de la etiqueta, indica la posición mediante cuadros delimitadores.
- Reconocimiento de texto (OCR): extrae texto impreso o manuscrito.
- Moderación de contenido: detecta material explícito o violento.
- Descripción o subtítulo: genera una frase que resume la escena.
- Detección de rostros y puntos de referencia: localiza caras, monumentos o logotipos.
Para el experimento del meme interesan sobre todo las etiquetas y las descripciones. Hay un cambio relevante en el panorama: Microsoft anunció que el servicio Image Analysis de Azure AI Vision se retirará el 25 de septiembre de 2028. Sigue funcionando y es útil incluirlo en la comparación, pero si empiezas un proyecto nuevo con horizonte largo, ten en cuenta esa fecha y revisa las opciones de migración que recomienda Microsoft.
Diseñar un banco de pruebas que sea justo
Comparar servicios con un puñado de capturas sueltas lleva a conclusiones engañosas. Un banco de pruebas útil necesita reglas claras desde el principio:
- Un conjunto de imágenes fijo, con la etiqueta correcta de cada una anotada en un archivo.
- Las mismas imágenes, en el mismo formato y tamaño, enviadas a todos los servicios.
- Un criterio de acierto definido antes de ver los resultados, para no ajustar la vara a conveniencia.
- Métricas de calidad, pero también de latencia y coste por imagen.
- Resultados guardados en bruto para poder revisarlos y repetir el análisis.
La estructura del proyecto puede ser esta:
banco-vision/
├── dataset/
│   ├── etiquetas.csv
│   ├── img_01.jpg
│   ├── img_02.jpg
│   └── ...
├── clasificadores/
│   ├── __init__.py
│   ├── base.py
│   ├── google_vision.py
│   ├── rekognition.py
│   ├── azure_vision.py
│   ├── multimodal.py
│   └── clip_local.py
├── resultados/
├── comparar.py
└── requirements.txt
El archivo etiquetas.csv asocia cada imagen con su clase real:
archivo,clase
img_01.jpg,chihuahua
img_02.jpg,muffin
img_03.jpg,chihuahua
img_04.jpg,muffin
Un consejo práctico: no te limites al meme original. Añade imágenes de tu propio dominio, porque el rendimiento en fotos virales dice poco sobre cómo se comportará un servicio con las fotos de tu tienda, tu almacén o tus usuarios. Otros pares clásicos de confusión, como labradoodle frente a pollo frito o perro pastor frente a fregona, sirven para ampliar la prueba.
Preparar el entorno en Python
Crea un entorno virtual e instala los clientes oficiales de cada servicio. Las versiones actuales de las librerías principales requieren Python 3.10 o superior; Python 3.13 o 3.14 son opciones cómodas para este proyecto.
python3 -m venv .venv
source .venv/bin/activate

pip install google-cloud-vision boto3 azure-ai-vision-imageanalysis \
  anthropic "transformers>=5" torch torchvision pillow
El archivo requirements.txt deja constancia de las dependencias:
google-cloud-vision>=3.16
boto3
azure-ai-vision-imageanalysis
anthropic
transformers>=5
torch>=2.14
torchvision>=0.29
pillow
Para que el código de comparación sea independiente de cada proveedor, define una interfaz común en clasificadores/base.py. Cada clasificador recibe la ruta de una imagen y devuelve etiquetas normalizadas con una confianza entre 0 y 1:
from dataclasses import dataclass
from typing import Protocol


@dataclass
class Etiqueta:
    nombre: str
    confianza: float  # siempre entre 0 y 1


class Clasificador(Protocol):
    nombre: str

    def clasificar(self, ruta: str) -> list[Etiqueta]:
        ...


def leer_bytes(ruta: str) -> bytes:
    with open(ruta, "rb") as archivo:
        return archivo.read()
Las credenciales nunca deben ir en el código. Cada SDK las toma de variables de entorno o de archivos de configuración estándar:
export GOOGLE_APPLICATION_CREDENTIALS="$HOME/claves/vision-sa.json"
export AWS_PROFILE="vision-pruebas"
export AWS_REGION="us-east-1"
export AZURE_VISION_ENDPOINT="https://mi-recurso.cognitiveservices.azure.com/"
export AZURE_VISION_KEY="..."
export ANTHROPIC_API_KEY="..."
Google Cloud Vision: etiquetas con puntuación
Google Cloud Vision es uno de los servicios más maduros. Antes de usarlo debes habilitar la API en tu proyecto de Google Cloud y autenticarte, ya sea con una cuenta de servicio o con credenciales de aplicación predeterminadas. La versión actual de la librería de Python es la 3.16.
from google.cloud import vision

from .base import Etiqueta, leer_bytes


class GoogleVision:
    nombre = "google-vision"

    def __init__(self) -> None:
        self.cliente = vision.ImageAnnotatorClient()

    def clasificar(self, ruta: str) -> list[Etiqueta]:
        imagen = vision.Image(content=leer_bytes(ruta))
        respuesta = self.cliente.label_detection(image=imagen, max_results=10)

        if respuesta.error.message:
            raise RuntimeError(respuesta.error.message)

        return [
            Etiqueta(nombre=e.description.lower(), confianza=e.score)
            for e in respuesta.label_annotations
        ]
La respuesta incluye etiquetas ordenadas por puntuación. Para una magdalena típica, la salida podría parecerse a esta:
food            0.98
baked goods     0.95
muffin          0.91
blueberry       0.87
ingredient      0.84
Fíjate en un detalle que afectará al análisis: los servicios de etiquetado devuelven conceptos de distintos niveles de abstracción. “Food” es correcto pero inútil para la pregunta que te interesa, así que el criterio de acierto debe decidir qué etiquetas cuentan.
Amazon Rekognition: etiquetas con jerarquía
Amazon Rekognition ofrece la operación DetectLabels, que devuelve etiquetas acompañadas de sus categorías padre. Puedes enviar la imagen en bytes, con un límite de 5 MB, o referenciar un objeto de Amazon S3.
import boto3

from .base import Etiqueta, leer_bytes


class Rekognition:
    nombre = "rekognition"

    def __init__(self) -> None:
        self.cliente = boto3.client("rekognition")

    def clasificar(self, ruta: str) -> list[Etiqueta]:
        respuesta = self.cliente.detect_labels(
            Image={"Bytes": leer_bytes(ruta)},
            MaxLabels=10,
            MinConfidence=50,
        )
        return [
            Etiqueta(nombre=e["Name"].lower(), confianza=e["Confidence"] / 100)
            for e in respuesta["Labels"]
        ]
Observa la conversión de la confianza: Rekognition la expresa de 0 a 100, mientras que Google usa de 0 a 1. Normalizar estas escalas es imprescindible para comparar. Cada etiqueta de Rekognition incluye además una lista Parents, útil para agrupar resultados: “Chihuahua” suele venir acompañado de “Dog”, “Pet” y “Animal”.
Azure AI Vision: etiquetas y subtítulos
Azure AI Vision combina etiquetas con una descripción generada en lenguaje natural. El cliente actual para Python es azure-ai-vision-imageanalysis, y necesita el endpoint y la clave de tu recurso.
import os

from azure.ai.vision.imageanalysis import ImageAnalysisClient
from azure.ai.vision.imageanalysis.models import VisualFeatures
from azure.core.credentials import AzureKeyCredential

from .base import Etiqueta, leer_bytes


class AzureVision:
    nombre = "azure-vision"

    def __init__(self) -> None:
        self.cliente = ImageAnalysisClient(
            endpoint=os.environ["AZURE_VISION_ENDPOINT"],
            credential=AzureKeyCredential(os.environ["AZURE_VISION_KEY"]),
        )

    def clasificar(self, ruta: str) -> list[Etiqueta]:
        resultado = self.cliente.analyze(
            image_data=leer_bytes(ruta),
            visual_features=[VisualFeatures.TAGS, VisualFeatures.CAPTION],
        )
        etiquetas = [
            Etiqueta(nombre=t.name.lower(), confianza=t.confidence)
            for t in resultado.tags.list
        ]
        if resultado.caption:
            print(f"  subtítulo: {resultado.caption.text}")
        return etiquetas
La función de subtítulos no está disponible en todas las regiones de Azure, así que comprueba que tu recurso esté creado en una región compatible. Los subtítulos son reveladores en este experimento: una descripción como “un peluche marrón” indica que el modelo percibió algo con forma de animal, aunque no supo cuál.
Recuerda la fecha de retiro del servicio. Si los resultados te convencen para un proyecto nuevo, planifica desde el principio una capa de abstracción, como la interfaz Clasificador de este banco, que te permita cambiar de proveedor sin reescribir la aplicación.
Modelos multimodales: preguntar en lenguaje natural
Los modelos de lenguaje multimodales cambian la forma de abordar el problema. En lugar de devolver un catálogo de etiquetas, responden a una instrucción concreta. Eso permite plantear exactamente la pregunta que te interesa y pedir la respuesta en un formato estructurado.
Este ejemplo usa la API de Claude con el SDK oficial de Python. El nombre del modelo se lee de una variable de entorno, porque los proveedores publican versiones nuevas con frecuencia y conviene poder cambiarlo sin tocar el código:
import base64
import json
import os

import anthropic

from .base import Etiqueta, leer_bytes

INSTRUCCION = (
    "Clasifica la imagen en una sola de estas clases: chihuahua o muffin. "
    'Responde solo con JSON: {"clase": "...", "confianza": 0.0}'
)


class Multimodal:
    nombre = "claude"

    def __init__(self) -> None:
        self.cliente = anthropic.Anthropic()
        self.modelo = os.environ.get("CLAUDE_MODEL", "claude-sonnet-5-5")

    def clasificar(self, ruta: str) -> list[Etiqueta]:
        datos = base64.standard_b64encode(leer_bytes(ruta)).decode()
        respuesta = self.cliente.messages.create(
            model=self.modelo,
            max_tokens=100,
            messages=[{
                "role": "user",
                "content": [
                    {"type": "image", "source": {
                        "type": "base64", "media_type": "image/jpeg", "data": datos}},
                    {"type": "text", "text": INSTRUCCION},
                ],
            }],
        )
        resultado = json.loads(respuesta.content[0].text)
        return [Etiqueta(resultado["clase"].lower(), float(resultado["confianza"]))]
Hay que interpretar con cuidado la confianza que devuelve un modelo de lenguaje. A diferencia de la puntuación de un clasificador, es un valor que el modelo genera como texto y no una probabilidad calibrada. Úsala como orientación, no como métrica estadística.
La ventaja de este enfoque es la flexibilidad: puedes cambiar las clases, pedir una explicación o solicitar que indique “no estoy seguro” cuando la imagen es ambigua. El inconveniente es el coste por imagen, normalmente mayor que el de una API de etiquetado, y una latencia más alta.
Clasificación sin entrenamiento con CLIP en local
Si prefieres no enviar imágenes a terceros, puedes ejecutar un modelo abierto en tu propia máquina. CLIP permite la clasificación de imágenes sin entrenamiento específico: le das una lista de descripciones candidatas y calcula cuál encaja mejor con la imagen. Con la versión 5 de Transformers, publicada a comienzos de 2026, basta con un pipeline:
from transformers import pipeline

from .base import Etiqueta

CANDIDATAS = {
    "a photo of a chihuahua dog": "chihuahua",
    "a photo of a blueberry muffin": "muffin",
}


class ClipLocal:
    nombre = "clip-local"

    def __init__(self) -> None:
        self.pipeline = pipeline(
            "zero-shot-image-classification",
            model="openai/clip-vit-base-patch32",
        )

    def clasificar(self, ruta: str) -> list[Etiqueta]:
        resultados = self.pipeline(ruta, candidate_labels=list(CANDIDATAS))
        return [
            Etiqueta(nombre=CANDIDATAS[r["label"]], confianza=r["score"])
            for r in resultados
        ]
La primera ejecución descarga los pesos del modelo desde Hugging Face Hub y los guarda en caché. A partir de ahí funciona sin conexión, sin coste por llamada y sin que las imágenes salgan de tu infraestructura.
La redacción de las descripciones importa. Formularlas como “a photo of a…” suele mejorar los resultados porque se parece a los textos con los que se entrenó el modelo. Prueba variantes y quédate con la que mejor funcione en tu conjunto de validación, no en el de prueba.
Normalizar resultados y calcular métricas
Con todos los clasificadores implementados, comparar.py recorre el conjunto de datos, mide la latencia, aplica el criterio de acierto y guarda un resumen. El criterio debe definirse antes de ejecutar las pruebas. Aquí se usan dos niveles: uno estricto, que exige la etiqueta exacta en primera posición, y uno flexible, que acepta sinónimos cercanos en las tres primeras:
import csv
import json
import time
from pathlib import Path

from clasificadores.azure_vision import AzureVision
from clasificadores.clip_local import ClipLocal
from clasificadores.google_vision import GoogleVision
from clasificadores.multimodal import Multimodal
from clasificadores.rekognition import Rekognition

SINONIMOS = {
    "chihuahua": {"chihuahua"},
    "muffin": {"muffin", "blueberry muffin", "cupcake", "baked goods"},
}


def acierto(etiquetas, clase, estricto):
    if not etiquetas:
        return False
    if estricto:
        return etiquetas[0].nombre == clase
    nombres = {e.nombre for e in etiquetas[:3]}
    return bool(nombres & SINONIMOS[clase])


def main():
    dataset = Path("dataset")
    filas = list(csv.DictReader(open(dataset / "etiquetas.csv")))
    clasificadores = [GoogleVision(), Rekognition(), AzureVision(),
                      Multimodal(), ClipLocal()]
    resumen = {}

    for c in clasificadores:
        estrictos = flexibles = 0
        tiempos = []
        crudos = []
        for fila in filas:
            inicio = time.perf_counter()
            etiquetas = c.clasificar(str(dataset / fila["archivo"]))
            tiempos.append(time.perf_counter() - inicio)
            etiquetas.sort(key=lambda e: e.confianza, reverse=True)
            estrictos += acierto(etiquetas, fila["clase"], estricto=True)
            flexibles += acierto(etiquetas, fila["clase"], estricto=False)
            crudos.append({"archivo": fila["archivo"],
                           "etiquetas": [vars(e) for e in etiquetas[:5]]})

        total = len(filas)
        resumen[c.nombre] = {
            "precision_estricta": round(estrictos / total, 3),
            "precision_flexible": round(flexibles / total, 3),
            "latencia_media_s": round(sum(tiempos) / total, 3),
        }
        Path("resultados").mkdir(exist_ok=True)
        Path(f"resultados/{c.nombre}.json").write_text(
            json.dumps(crudos, indent=2, ensure_ascii=False))

    print(json.dumps(resumen, indent=2))


if __name__ == "__main__":
    main()
Una ejecución produce un resumen como el siguiente. Los números son ilustrativos; los tuyos dependerán de tus imágenes, del momento y de las versiones de cada servicio:
{
  "google-vision": {"precision_estricta": 0.812, "precision_flexible": 0.938, "latencia_media_s": 0.41},
  "rekognition":   {"precision_estricta": 0.562, "precision_flexible": 0.875, "latencia_media_s": 0.38},
  "azure-vision":  {"precision_estricta": 0.500, "precision_flexible": 0.812, "latencia_media_s": 0.52},
  "claude":        {"precision_estricta": 1.000, "precision_flexible": 1.000, "latencia_media_s": 2.10},
  "clip-local":    {"precision_estricta": 0.938, "precision_flexible": 0.938, "latencia_media_s": 0.09}
}
Con un conjunto pequeño, una sola imagen mueve la precisión en varios puntos. Antes de tomar decisiones, amplía la muestra a cientos de imágenes y, si quieres afinar, calcula también la matriz de confusión para ver qué clase se confunde con cuál.
Cómo interpretar lo que devuelven los servicios
Al revisar los resultados en bruto aparecen patrones que se repiten desde las primeras versiones de este experimento.
Los servicios de etiquetado reconocen casi siempre que hay un perro cuando la imagen es de un chihuahua, aunque no siempre aciertan la raza. Con las magdalenas el comportamiento es más irregular: algunos responden con etiquetas genéricas de panadería, como pan, galleta o cupcake, en lugar de la palabra exacta, y en las imágenes más ambiguas llegan a devolver conceptos animales, como hocico o peluche. Que un servicio responda “bollería” no es un error grave para muchos casos de uso, pero sí lo es si tu aplicación necesita la clase exacta.
Los modelos que reciben la pregunta cerrada, como CLIP con dos descripciones o un modelo multimodal con una instrucción, tienen ventaja en este tipo de prueba porque solo deben elegir entre dos opciones. Las APIs de etiquetado, en cambio, eligen entre miles de conceptos posibles. Comparar ambos enfoques es legítimo, pero conviene entender que no resuelven exactamente el mismo problema.
Hay otro matiz: algunos servicios históricos combinaban revisión humana con inteligencia artificial para producir descripciones más precisas a cambio de una latencia mucho mayor. Si tu caso de uso tolera esperas largas y exige precisión máxima, la revisión humana sigue siendo una opción válida, normalmente aplicada solo a los casos de baja confianza.
Ajuste fino con PyTorch cuando nada encaja
Si ninguno de los servicios alcanza la precisión que necesitas en tus categorías, el siguiente paso es entrenar tu propio clasificador. No hace falta empezar desde cero: el ajuste fino de modelos preentrenados aprovecha lo que una red ya aprendió con millones de imágenes y lo adapta a tus clases con pocos cientos de ejemplos.
Con PyTorch 2.14 y torchvision 0.29, el proceso con una ResNet-50 es el siguiente. Primero organiza las imágenes en carpetas por clase:
datos/
├── entrenamiento/
│   ├── chihuahua/
│   └── muffin/
└── validacion/
    ├── chihuahua/
    └── muffin/
Después carga el modelo con sus pesos preentrenados, congela las capas convolucionales y sustituye la capa final por una de dos salidas:
import torch
from torch import nn
from torch.utils.data import DataLoader
from torchvision import datasets
from torchvision.models import ResNet50_Weights, resnet50

dispositivo = "cuda" if torch.cuda.is_available() else "cpu"
pesos = ResNet50_Weights.DEFAULT
transformacion = pesos.transforms()

entrenamiento = datasets.ImageFolder("datos/entrenamiento", transform=transformacion)
validacion = datasets.ImageFolder("datos/validacion", transform=transformacion)
cargador_ent = DataLoader(entrenamiento, batch_size=32, shuffle=True)
cargador_val = DataLoader(validacion, batch_size=32)

modelo = resnet50(weights=pesos)
for parametro in modelo.parameters():
    parametro.requires_grad = False
modelo.fc = nn.Linear(modelo.fc.in_features, len(entrenamiento.classes))
modelo = modelo.to(dispositivo)

optimizador = torch.optim.AdamW(modelo.fc.parameters(), lr=1e-3)
criterio = nn.CrossEntropyLoss()

for epoca in range(5):
    modelo.train()
    for imagenes, clases in cargador_ent:
        imagenes, clases = imagenes.to(dispositivo), clases.to(dispositivo)
        optimizador.zero_grad()
        perdida = criterio(modelo(imagenes), clases)
        perdida.backward()
        optimizador.step()

    modelo.eval()
    aciertos = 0
    with torch.no_grad():
        for imagenes, clases in cargador_val:
            predicciones = modelo(imagenes.to(dispositivo)).argmax(dim=1)
            aciertos += (predicciones.cpu() == clases).sum().item()
    print(f"época {epoca + 1}: precisión de validación {aciertos / len(validacion):.3f}")

torch.save(modelo.state_dict(), "clasificador_chihuahua_muffin.pt")
época 1: precisión de validación 0.912
época 2: precisión de validación 0.947
época 3: precisión de validación 0.958
época 4: precisión de validación 0.963
época 5: precisión de validación 0.965
pesos.transforms() aplica exactamente el preprocesamiento con el que se entrenó el modelo original: redimensionado, recorte y normalización. Usarlo evita uno de los errores más comunes en transfer learning. Cuando la precisión se estanque, puedes descongelar los últimos bloques de la red y seguir entrenando con una tasa de aprendizaje más baja.
Costes, latencia y privacidad
La precisión no es el único criterio. En producción pesan igual o más otros factores.
En coste, las APIs de etiquetado cobran por cada mil imágenes procesadas, con niveles gratuitos mensuales para empezar. Los modelos multimodales facturan por tokens, y una imagen consume una cantidad de tokens que depende de su resolución. Un modelo local no tiene coste por llamada, pero sí de infraestructura: servidores, GPU y mantenimiento.
En latencia, los servicios de etiquetado suelen responder en fracciones de segundo, mientras que un modelo multimodal tarda más porque genera texto. Un modelo pequeño como CLIP en una GPU local puede clasificar decenas de imágenes por segundo.
En privacidad, enviar imágenes a terceros puede chocar con normativas o contratos, sobre todo si contienen personas, documentos o información médica. Revisa los términos de retención de datos de cada proveedor y valora el procesamiento local cuando los datos sean sensibles.
Una optimización sencilla y eficaz es reducir el tamaño de las imágenes antes de enviarlas. La mayoría de modelos trabaja internamente con resoluciones moderadas, así que mandar fotos de 12 megapíxeles solo aumenta la latencia y el coste:
from io import BytesIO

from PIL import Image


def preparar(ruta: str, lado_max: int = 1024) -> bytes:
    with Image.open(ruta) as imagen:
        imagen = imagen.convert("RGB")
        imagen.thumbnail((lado_max, lado_max))
        bufer = BytesIO()
        imagen.save(bufer, format="JPEG", quality=90)
        return bufer.getvalue()
Errores comunes al evaluar servicios de visión
Algunos fallos de método invalidan una comparación entera. Conviene evitarlos desde el diseño.
Evaluar con muy pocas imágenes. Con dieciséis fotos, un acierto de diferencia equivale a más de seis puntos porcentuales. Usa conjuntos amplios y representativos de tu caso de uso.
Definir el criterio de acierto después de ver los resultados. Es fácil, sin darse cuenta, elegir sinónimos que favorecen al servicio que ya te gustaba. Fija el criterio antes de ejecutar.
Mezclar escalas de confianza. Si un servicio devuelve valores de 0 a 100 y otro de 0 a 1, cualquier umbral común dará resultados absurdos. Normaliza siempre.
Ajustar las instrucciones con el conjunto de prueba. Si modificas las descripciones de CLIP o la instrucción del modelo multimodal mirando el resultado en las mismas imágenes que usas para medir, estás sobreajustando. Separa validación y prueba.
Ignorar la orientación de las fotos. Muchas imágenes de móvil guardan la rotación en los metadatos EXIF. Algunos servicios la respetan y otros no. Corrígela antes de enviar con ImageOps.exif_transpose de Pillow.
Fijar el nombre del modelo en el código. Los proveedores actualizan sus modelos y retiran versiones. Léelo de la configuración y registra en los resultados qué versión se usó en cada ejecución.
Solución de problemas: mensajes de error frecuentes
Estos son los errores más habituales al poner en marcha el banco de pruebas, con su causa y solución.
Credenciales de Google no encontradas:
google.auth.exceptions.DefaultCredentialsError: Your default credentials were not found.
Define GOOGLE_APPLICATION_CREDENTIALS con la ruta del archivo de la cuenta de servicio, o ejecuta gcloud auth application-default login en tu entorno de desarrollo.
API de Google sin habilitar:
google.api_core.exceptions.PermissionDenied: 403 Cloud Vision API has not been used in project 123456789 before or it is disabled.
Habilita la API en la consola de Google Cloud o con la línea de comandos y espera unos minutos a que se propague:
gcloud services enable vision.googleapis.com
Credenciales de AWS ausentes:
botocore.exceptions.NoCredentialsError: Unable to locate credentials
Configura un perfil con aws configure o define AWS_PROFILE. Comprueba también que la región elegida ofrece Rekognition.
Imagen demasiado grande para Rekognition:
botocore.errorfactory.ImageTooLargeException: An error occurred (ImageTooLargeException) when calling the DetectLabels operation
Reduce la imagen con la función preparar o súbela a S3 y referencia el objeto, que admite archivos más grandes.
Clave o endpoint de Azure incorrectos:
azure.core.exceptions.ClientAuthenticationError: (401) Access denied due to invalid subscription key or wrong API endpoint.
Verifica que la clave corresponde al recurso del endpoint configurado y que este incluye la barra final.
Límite de peticiones en la API multimodal:
anthropic.RateLimitError: Error code: 429
Reduce la concurrencia y reintenta con espera exponencial. El SDK ya reintenta algunos errores automáticamente; puedes ajustar el número con el parámetro max_retries del cliente.
Respuesta que no es JSON válido:
json.decoder.JSONDecodeError: Expecting value: line 1 column 1 (char 0)
El modelo añadió texto alrededor del JSON. Refuerza la instrucción, valida la salida y, si persiste, extrae el primer objeto JSON de la respuesta antes de interpretarlo.
Memoria de GPU insuficiente al entrenar:
torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 256.00 MiB.
Reduce batch_size, usa precisión mixta con torch.autocast o entrena en CPU con un subconjunto mientras pruebas el código.
Casos de uso reales
La comparación entre chihuahuas y magdalenas es un juego, pero la técnica de evaluación se aplica a problemas serios.
En comercio electrónico, el etiquetado automático de fotos de productos alimenta buscadores y filtros. Aquí importa la granularidad: distinguir “zapatilla de correr” de “zapatilla de baloncesto” vale más que reconocer “calzado”.
En moderación de contenido, las plataformas combinan APIs de detección con revisión humana para los casos de baja confianza, exactamente el patrón híbrido descrito antes.
En control de calidad industrial, los modelos entrenados con ajuste fino detectan defectos en piezas sobre una línea de producción, donde los servicios genéricos no conocen las categorías específicas.
En accesibilidad, los modelos multimodales generan descripciones alternativas de imágenes para personas con discapacidad visual, y su capacidad de describir la escena completa es una ventaja frente al etiquetado.
En agricultura y medio ambiente, clasificadores propios identifican plagas, especies o el estado de cultivos a partir de fotos tomadas en campo, a menudo ejecutados en dispositivos sin conexión.
Conclusiones
El viejo meme del chihuahua y la magdalena sigue siendo una buena excusa para recordar que la visión artificial no es magia: cada servicio ve el mundo a través de los datos con los que se entrenó y del catálogo de respuestas que puede dar. Las APIs de etiquetado reconocen bien categorías amplias, los modelos multimodales permiten hacer preguntas precisas en lenguaje natural y los modelos abiertos como CLIP ofrecen clasificación sin entrenamiento, sin coste por llamada y sin sacar las imágenes de tu infraestructura.
La lección más útil no es qué servicio ganó en un conjunto de dieciséis fotos, sino cómo medir con rigor. Un banco de pruebas propio, con una interfaz común, confianzas normalizadas, criterios fijados de antemano y métricas de calidad, latencia y coste, te permite decidir con datos y cambiar de proveedor cuando haga falta, algo especialmente relevante ahora que servicios como Azure Image Analysis tienen fecha de retiro.
Y cuando ningún servicio genérico alcance la precisión que necesitas, el ajuste fino de una red preentrenada con PyTorch y unos cientos de imágenes de tu dominio suele cerrar la brecha. Empieza por el enfoque más sencillo, mide con tus propios datos y sube de complejidad solo cuando los números lo justifiquen.