Introduccion a la clasificacion de texto
La clasificacion de texto es una de las aplicaciones mas extendidas del aprendizaje automatico. Consiste en asignar una etiqueta o categoria a un fragmento de texto a partir de ejemplos previos. Los filtros de correo no deseado, los sistemas de moderacion de comentarios, el analisis de sentimiento en reseñas de productos y la categorizacion automatica de tickets de soporte son casos de uso cotidianos.
En 2026 las tecnicas han evolucionado desde los modelos clasicos basados en bolsas de palabras hasta arquitecturas transformer de gran escala. Sin embargo, los fundamentos siguen siendo los mismos: representar el texto de forma numerica, entrenar un modelo capaz de discriminar entre clases y evaluar su capacidad de generalizacion. TensorFlow y su API de alto nivel Keras continuan siendo herramientas solidas para experimentar y desplegar este tipo de sistemas, especialmente cuando se busca control total sobre la arquitectura y el pipeline de datos.
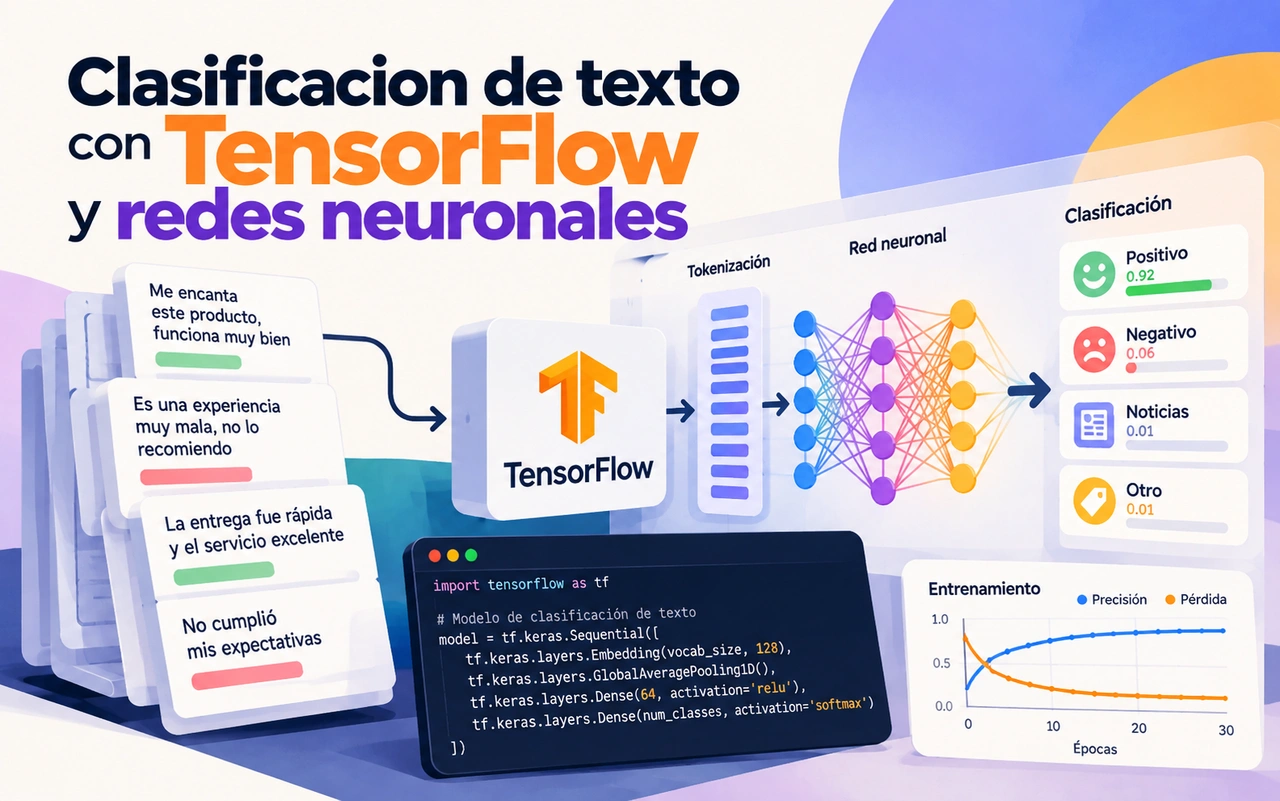
Este articulo presenta los conceptos esenciales de machine learning aplicados a la clasificacion de texto, muestra como construir redes feedforward y recurrentes, y explica las practicas actuales de preparacion de datos, vectorizacion y evaluacion de modelos. Los ejemplos se centran en tareas de clasificacion binaria y multiclasse utilizando conjuntos de datos publicos.
Conceptos basicos de aprendizaje automatico
El aprendizaje supervisado parte de un conjunto de ejemplos etiquetados. Cada ejemplo contiene un conjunto de caracteristicas de entrada y una salida deseada. En clasificacion de texto, las caracteristicas son los tokens o las representaciones vectoriales del documento, y la salida es la clase a la que pertenece.
Es fundamental distinguir entre los conjuntos de entrenamiento, validacion y prueba. El conjunto de entrenamiento se utiliza para ajustar los parametros del modelo. El de validacion permite seleccionar hiperparametros y detectar sobreajuste. El de prueba se reserva para una evaluacion final no sesgada. Una division habitual es 70 por ciento entrenamiento, 15 por ciento validacion y 15 por ciento prueba, aunque las proporciones pueden variar segun el volumen de datos.
Las metricas de rendimiento dependen del tipo de problema. En clasificacion binaria se emplean accuracy, precision, recall y F1-score. Cuando las clases estan desbalanceadas, accuracy puede resultar engañosa y conviene prestar atencion a las metricas por clase o a la matriz de confusion.
La funcion de perdida mide la discrepancia entre las predicciones del modelo y las etiquetas reales. Para clasificacion binaria se utiliza binary crossentropy. Para problemas multiclasse se recurre a categorical crossentropy o sparse categorical crossentropy segun el formato de las etiquetas.
Representacion numerica del texto
Los modelos de aprendizaje automatico no operan directamente sobre cadenas de caracteres. El texto debe convertirse en tensores numericos. El proceso tipico incluye estandarizacion, tokenizacion y vectorizacion.
La estandarizacion elimina ruido: conversion a minusculas, eliminacion de signos de puntuacion y, en algunos casos, eliminacion de etiquetas HTML. La tokenizacion divide el texto en unidades significativas, normalmente palabras o subpalabras. La vectorizacion asigna a cada token un indice entero o un vector denso.
Keras ofrece la capa TextVectorization, que combina estos pasos de forma eficiente:
import tensorflow as tf

vectorize_layer = tf.keras.layers.TextVectorization(
    max_tokens=10000,
    output_mode='int',
    output_sequence_length=250
)

# Adaptar al corpus de entrenamiento
vectorize_layer.adapt(train_texts)
Una vez adaptada, la capa puede aplicarse a cualquier texto y producir secuencias de enteros de longitud fija. Los tokens desconocidos se mapean a un indice especial de fuera de vocabulario.
Otra alternativa clasica es la representacion TF-IDF, que pondera la frecuencia de cada termino por su rareza en el corpus. Aunque ha perdido protagonismo frente a los embeddings densos, sigue siendo competitiva en conjuntos de datos pequenos y cuando se prioriza la interpretabilidad.
Construccion de un clasificador feedforward
Una red feedforward sencilla puede resolver problemas de clasificacion de texto cuando se combina con una representacion adecuada. El flujo tipico consiste en una capa de embedding seguida de una o varias capas densas y una capa de salida con activacion sigmoid o softmax.
El siguiente ejemplo ilustra un modelo binario para analisis de sentimiento:
model = tf.keras.Sequential([
    vectorize_layer,
    tf.keras.layers.Embedding(input_dim=10000, output_dim=64),
    tf.keras.layers.GlobalAveragePooling1D(),
    tf.keras.layers.Dense(64, activation='relu'),
    tf.keras.layers.Dropout(0.5),
    tf.keras.layers.Dense(1, activation='sigmoid')
])

model.compile(
    loss='binary_crossentropy',
    optimizer='adam',
    metrics=['accuracy']
)
La capa Embedding aprende una representacion densa de cada token. GlobalAveragePooling1D reduce la secuencia a un unico vector promediando a lo largo de la dimension temporal. Las capas densas posteriores realizan la discriminacion final.
Durante el entrenamiento es recomendable utilizar callbacks como EarlyStopping y ReduceLROnPlateau para evitar el sobreajuste y ajustar la tasa de aprendizaje de forma dinamica.
callbacks = [
    tf.keras.callbacks.EarlyStopping(patience=3, restore_best_weights=True),
    tf.keras.callbacks.ReduceLROnPlateau(factor=0.5, patience=2)
]

history = model.fit(
    train_ds,
    validation_data=val_ds,
    epochs=20,
    callbacks=callbacks
)
Redes neuronales recurrentes para texto
Las redes feedforward tratan la secuencia como una bolsa de embeddings promediados y pierden informacion sobre el orden de las palabras. Las redes recurrentes, y en particular las LSTM y GRU, mantienen un estado interno que se actualiza a medida que procesan cada token, capturando dependencias a corto y medio plazo.
Una arquitectura bidireccional LSTM es un punto de partida solido:
model = tf.keras.Sequential([
    vectorize_layer,
    tf.keras.layers.Embedding(input_dim=10000, output_dim=64, mask_zero=True),
    tf.keras.layers.Bidirectional(tf.keras.layers.LSTM(64)),
    tf.keras.layers.Dense(64, activation='relu'),
    tf.keras.layers.Dropout(0.5),
    tf.keras.layers.Dense(1, activation='sigmoid')
])
La opcion mask_zero indica a la red que ignore los tokens de relleno. La capa Bidirectional procesa la secuencia en ambas direcciones y concatena los estados finales, lo que suele mejorar el rendimiento en tareas de clasificacion.
Para secuencias mas largas o cuando se necesita mayor capacidad, se pueden apilar varias capas LSTM con return_sequences=True en las capas intermedias:
model = tf.keras.Sequential([
    vectorize_layer,
    tf.keras.layers.Embedding(10000, 64, mask_zero=True),
    tf.keras.layers.Bidirectional(tf.keras.layers.LSTM(64, return_sequences=True)),
    tf.keras.layers.Bidirectional(tf.keras.layers.LSTM(32)),
    tf.keras.layers.Dense(64, activation='relu'),
    tf.keras.layers.Dense(1)
])
Preparacion de conjuntos de datos con tf.data
TensorFlow recomienda el uso de la API tf.data para construir pipelines de datos eficientes. La utilidad text_dataset_from_directory permite cargar textos organizados en carpetas por clase:
batch_size = 32
seed = 42

raw_train_ds = tf.keras.utils.text_dataset_from_directory(
    'aclImdb/train',
    batch_size=batch_size,
    validation_split=0.2,
    subset='training',
    seed=seed
)

raw_val_ds = tf.keras.utils.text_dataset_from_directory(
    'aclImdb/train',
    batch_size=batch_size,
    validation_split=0.2,
    subset='validation',
    seed=seed
)
El pipeline puede enriquecerse con operaciones de cache, shuffle y prefetch para maximizar el uso de la GPU:
AUTOTUNE = tf.data.AUTOTUNE

train_ds = raw_train_ds.cache().prefetch(buffer_size=AUTOTUNE)
val_ds = raw_val_ds.cache().prefetch(buffer_size=AUTOTUNE)
Cuando el texto requiere limpieza adicional, se puede aplicar una funcion de estandarizacion personalizada antes de la vectorizacion.
Transferencia de aprendizaje con embeddings preentrenados
Entrenar embeddings desde cero requiere grandes volumenes de datos. Una alternativa efectiva es partir de embeddings preentrenados disponibles en TensorFlow Hub o en repositorios de modelos. Estos embeddings capturan conocimiento linguistico general y pueden ajustarse finamente a la tarea especifica.
import tensorflow_hub as hub

hub_layer = hub.KerasLayer(
    "https://tfhub.dev/google/nnlm-en-dim50/2",
    input_shape=[],
    dtype=tf.string,
    trainable=True
)

model = tf.keras.Sequential([
    hub_layer,
    tf.keras.layers.Dense(16, activation='relu'),
    tf.keras.layers.Dense(1)
])
En 2026 es habitual utilizar tambien modelos transformer ligeros mediante TensorFlow Hub o la libreria transformers de Hugging Face, especialmente cuando se dispone de recursos de computacion moderados y se busca un equilibrio entre precision y latencia.
Evaluacion y diagnostico de modelos
Despues del entrenamiento es necesario examinar las curvas de perdida y accuracy tanto en entrenamiento como en validacion. Un aumento de la perdida de validacion mientras la de entrenamiento continua disminuyendo indica sobreajuste. En ese caso se puede aumentar el dropout, reducir la capacidad del modelo o aplicar tecnicas de regularizacion adicionales.
La matriz de confusion revela que clases se confunden con mayor frecuencia. En problemas de moderacion de contenido, por ejemplo, los falsos negativos (contenido toxico clasificado como aceptable) suelen ser mas costosos que los falsos positivos.
La calibracion de las probabilidades de salida es otro aspecto critico en produccion. Un modelo bien calibrado produce scores que reflejan la confianza real. Tecnicas como temperature scaling o isotonic regression pueden aplicarse a posteriori sin necesidad de reentrenar.
Consideraciones de produccion
Un modelo que acepta texto crudo como entrada simplifica el despliegue. Para ello la capa de vectorizacion debe formar parte del grafo del modelo en lugar de aplicarse fuera de el. De este modo el servicio recibe cadenas de texto y devuelve predicciones sin pasos intermedios manuales.
El tamaño del vocabulario, la longitud maxima de secuencia y el numero de parametros del modelo influyen directamente en la latencia y el consumo de memoria. En entornos con restricciones estrictas de recursos, los modelos basados en n-gramas de caracteres o en embeddings de baja dimension pueden ofrecer un mejor compromiso accuracy-coste.
El monitoreo continuo del rendimiento en produccion permite detectar degradacion causada por cambios en la distribucion de los datos de entrada. Retraining periodico o pipelines de aprendizaje continuo mitigan este problema.
Limitaciones y perspectivas actuales
Las redes recurrentes y los modelos feedforward siguen siendo utiles para problemas de tamaño moderado y cuando se requiere interpretabilidad o bajo coste computacional. Sin embargo, en 2026 la mayoria de los sistemas de clasificacion de texto de alto rendimiento se basan en arquitecturas transformer preentrenadas y ajustadas a la tarea.
La calibracion, la robustez ante entradas adversarias y la capacidad de explicar las predicciones son areas activas de investigacion. Un modelo que no solo clasifica correctamente sino que comunica su incertidumbre aporta mayor valor en entornos de decision critica.
Conclusiones
La clasificacion de texto con TensorFlow combina principios solidos de aprendizaje automatico con herramientas flexibles de construccion de modelos. Desde la preparacion de datos y la vectorizacion hasta el diseño de redes feedforward y recurrentes, cada etapa influye en el rendimiento final.
Comprender estos fundamentos permite abordar problemas reales de forma informada, elegir la arquitectura adecuada segun el volumen de datos y los requisitos de latencia, y evolucionar hacia soluciones mas avanzadas cuando las necesidades lo exijan. La experimentacion sistematica, el uso de conjuntos de validacion y la atencion a las metricas relevantes son practicas que distinguen un prototipo funcional de un sistema robusto en produccion.