El problema de ponerse de acuerdo sobre el orden
Imagina que dos personas intercambian números escritos en tarjetas, pero una de ellas lee las cifras de izquierda a derecha y la otra de derecha a izquierda. El número 2984 de la primera se convertiría en 4892 para la segunda. Ninguna está equivocada; simplemente siguen convenciones distintas. Y mientras no se den cuenta, todos los intercambios estarán corruptos.
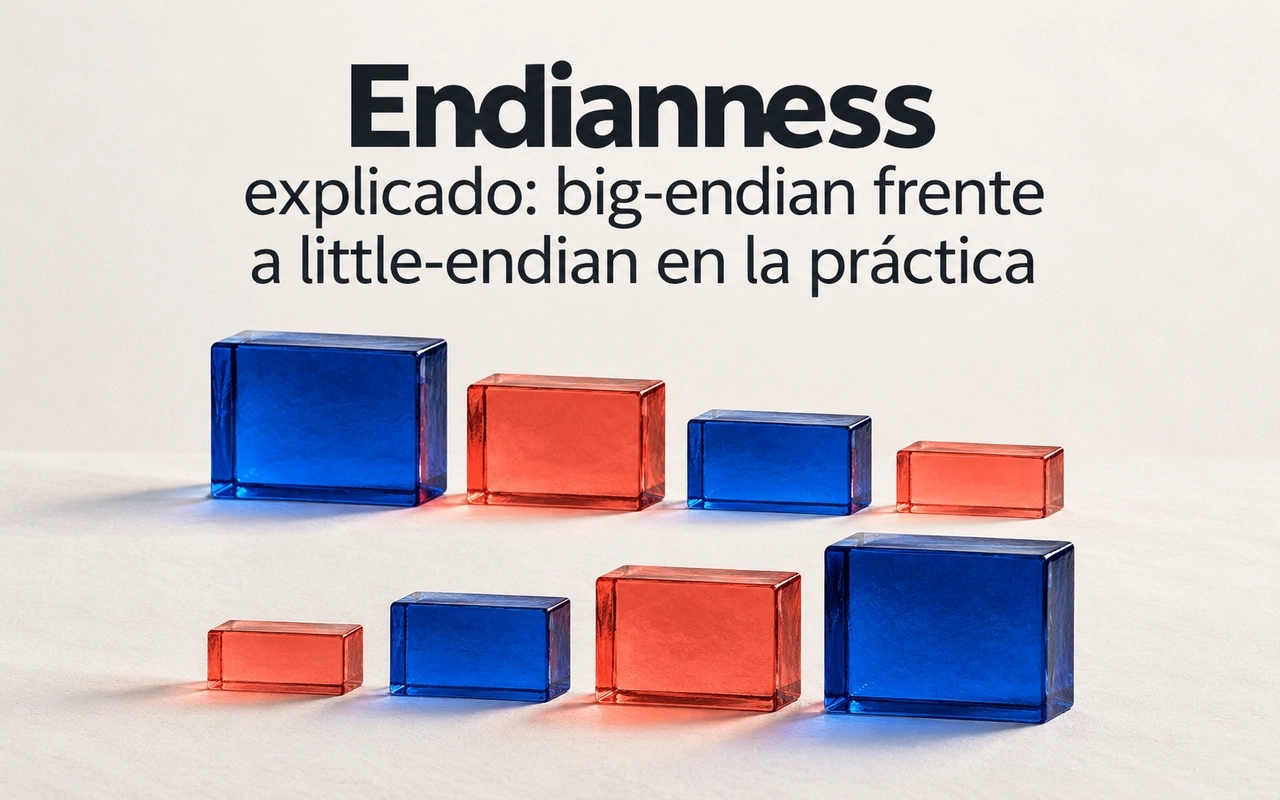
Exactamente eso ocurre entre ordenadores con el endianness. Cuando un valor ocupa más de un byte, como un entero de 32 bits o un número de coma flotante, el procesador tiene que decidir en qué orden guarda esos bytes en memoria. Hay dos convenciones principales, big-endian y little-endian, y distintos sistemas han elegido cada una de ellas.
La mayor parte del tiempo, los lenguajes de alto nivel ocultan este detalle. Pero en cuanto se leen archivos binarios, se implementan protocolos de red, se trabaja con hardware, se depura memoria o se intercambian datos entre plataformas, el endianness aparece y, si se ignora, produce errores desconcertantes: valores enormes donde debería haber números pequeños, puertos incorrectos o imágenes corruptas.
En esta guía veremos qué es exactamente el endianness, cómo se representan los datos en cada convención, qué arquitecturas usan cada una, por qué las redes adoptaron big-endian y cómo manejar correctamente el orden de los bytes en C, Python y JavaScript.
Bits, bytes y valores de varios bytes
Un ordenador trabaja con bits, ceros y unos. Ocho bits forman un byte, la unidad mínima de memoria direccionable: cada byte de la memoria tiene su propia dirección.
Un byte puede representar 256 valores distintos, del 0 al 255. Para números mayores se necesitan varios bytes. Un entero de 16 bits ocupa dos, uno de 32 bits ocupa cuatro y uno de 64 bits, ocho.
Tomemos el número 0x0A0B0C0D, que en decimal es 168496141. En hexadecimal se ve con claridad que está formado por cuatro bytes: 0A, 0B, 0C y 0D. Al guardarlo en memoria, ocupará cuatro direcciones consecutivas. La pregunta es: ¿qué byte va en la primera dirección?
Es importante entender que el endianness afecta al orden de los bytes, no al de los bits dentro de cada byte. El byte 0x0C es siempre 00001100, en cualquier arquitectura. Por eso un valor de un solo byte, como un carácter ASCII, no tiene problemas de endianness.
El byte más significativo
Para describir las dos convenciones necesitamos un concepto previo: la significancia de un byte.
En el número decimal 2984, el 2 es la cifra más significativa: cambiarla altera el valor en miles. El 4 es la menos significativa: cambiarla altera el valor en unidades. Con los bytes ocurre lo mismo. En 0x0A0B0C0D, el byte 0A es el más significativo, el MSB por sus siglas en inglés, porque representa los valores más altos, y 0D es el menos significativo, el LSB.
Valor:        0x0A0B0C0D
               │       │
               │       └── byte menos significativo (LSB): 0x0D
               └────────── byte más significativo (MSB): 0x0A
Big-endian y little-endian
Las dos convenciones se definen por qué byte se guarda primero, en la dirección de memoria más baja.
En big-endian se almacena el byte más significativo primero. El orden en memoria coincide con la forma en que escribimos el número:
Dirección:   0x1000  0x1001  0x1002  0x1003
Big-endian:    0A      0B      0C      0D
En little-endian se almacena primero el byte menos significativo, de modo que el número aparece al revés:
Dirección:      0x1000  0x1001  0x1002  0x1003
Little-endian:    0D      0C      0B      0A
Los nombres proceden de Los viajes de Gulliver, donde dos pueblos se enfrentan por si un huevo cocido debe romperse por el extremo grande o por el pequeño. El informático Danny Cohen tomó la metáfora en 1980 para describir este debate, igual de arbitrario: ninguna de las dos opciones es intrínsecamente mejor.
Cada una tiene, eso sí, pequeñas ventajas. Big-endian resulta más natural de leer en volcados de memoria y permite comparar números como cadenas de bytes. Little-endian facilita algunas operaciones aritméticas, porque los bytes de menor peso, por los que empiezan las sumas con acarreo, están en las direcciones más bajas, y permite leer un valor con un tamaño menor desde la misma dirección: los primeros dos bytes de un entero de 32 bits pequeño contienen el mismo valor como entero de 16 bits.
Existe también un tercer caso, el bi-endian: procesadores capaces de trabajar en ambos modos, configurables por el sistema operativo.
Quién usa cada convención
Hoy, la inmensa mayoría de los procesadores de uso general funcionan en little-endian. Los x86 y x86-64 de Intel y AMD, que dominan los ordenadores personales y los servidores, son little-endian. ARM es técnicamente bi-endian, pero prácticamente todos los sistemas operativos lo usan en modo little-endian, incluidos Android, iOS, macOS en los procesadores Apple Silicon, Windows en ARM y las distribuciones Linux. RISC-V, la arquitectura abierta en auge, también es little-endian por defecto.
Big-endian sobrevive en nichos importantes. IBM Z, los mainframes que siguen procesando gran parte de las transacciones bancarias del mundo, son big-endian. También lo eran las antiguas arquitecturas SPARC, PowerPC en sus usos clásicos o los Motorola 68000. Y, sobre todo, big-endian es la convención de los protocolos de red y de muchos formatos de archivo.
Puedes comprobar el orden de tu sistema desde Python:
import sys
print(sys.byteorder)
little
Detectar el endianness en C
En C podemos observar directamente cómo se almacena un número inspeccionando su memoria byte a byte con un puntero a unsigned char:
#include <stdio.h>
#include <stdint.h>

int main(void) {
    uint32_t valor = 0x0A0B0C0D;
    unsigned char *bytes = (unsigned char *)&valor;

    for (int i = 0; i < 4; i++) {
        printf("byte %d: %02X\n", i, bytes[i]);
    }
    return 0;
}
En un equipo x86-64 o ARM, la salida muestra el orden invertido:
byte 0: 0D
byte 1: 0C
byte 2: 0B
byte 3: 0A
A partir de esta idea, la forma clásica de detectar el endianness en tiempo de ejecución es guardar el valor 1 en un entero y comprobar si el primer byte de su memoria vale 1:
#include <stdio.h>

int es_little_endian(void) {
    unsigned int prueba = 1;
    return *(unsigned char *)&prueba == 1;
}

int main(void) {
    puts(es_little_endian() ? "Little endian" : "Big endian");
    return 0;
}
Little endian
En little-endian, el byte menos significativo, que contiene el 1, está en la primera posición. En big-endian estaría al final, y el primer byte valdría 0.
En la práctica, es mejor resolver esto en tiempo de compilación. C23 incorporó al estándar la cabecera stdbit.h con las macros __STDC_ENDIAN_NATIVE__, __STDC_ENDIAN_LITTLE__ y __STDC_ENDIAN_BIG__, y GCC y Clang ofrecen desde hace tiempo __BYTE_ORDER__:
#if __BYTE_ORDER__ == __ORDER_LITTLE_ENDIAN__
    /* código para little-endian */
#else
    /* código para big-endian */
#endif
El orden de bytes de red
Cuando los primeros protocolos de Internet se diseñaron, en los años setenta y ochenta, había que escoger una convención común para que máquinas con arquitecturas distintas se entendieran. Se eligió big-endian, y desde entonces se conoce como orden de bytes de red, o network byte order en inglés. Todos los campos de varios bytes de las cabeceras de IP, TCP y UDP, como los puertos, las longitudes o las direcciones, viajan en big-endian.
Esto significa que un equipo little-endian debe convertir los valores antes de enviarlos y después de recibirlos. La API de sockets ofrece cuatro funciones para ello:
#include <arpa/inet.h>

uint32_t htonl(uint32_t valor_host);   /* host to network, 32 bits */
uint16_t htons(uint16_t valor_host);   /* host to network, 16 bits */
uint32_t ntohl(uint32_t valor_red);    /* network to host, 32 bits */
uint16_t ntohs(uint16_t valor_red);    /* network to host, 16 bits */
En un sistema big-endian, estas funciones no hacen nada; en uno little-endian, invierten los bytes. Usarlas siempre hace que el código sea portable:
#include <stdio.h>
#include <stdint.h>
#include <arpa/inet.h>

int main(void) {
    uint16_t puerto = 8080;
    uint16_t puerto_red = htons(puerto);
    printf("host: %u (0x%04X)\nred:  %u (0x%04X)\n",
           puerto, puerto, puerto_red, puerto_red);
    return 0;
}
host: 8080 (0x1F90)
red:  36895 (0x901F)
El valor 36895 es lo que obtendrías si interpretaras como número nativo los bytes que viajan por la red. Este es precisamente el error típico: olvidar htons al configurar un socket hace que el programa escuche en un puerto distinto del esperado.
struct sockaddr_in direccion = {0};
direccion.sin_family = AF_INET;
direccion.sin_port = htons(8080);            /* correcto */
direccion.sin_addr.s_addr = htonl(INADDR_ANY);
Endianness en Python
Python oculta el endianness en sus enteros, pero lo expone cuando se convierten a bytes. Los métodos to_bytes y from_bytes reciben el orden de forma explícita:
numero = 2984

print(numero.to_bytes(2, "big").hex(" "))
print(numero.to_bytes(2, "little").hex(" "))

datos = bytes([0x00, 0x00, 0x01, 0x2C])
print(int.from_bytes(datos, "big"))
print(int.from_bytes(datos, "little"))
0b a8
a8 0b
300
738263040
El mismo grupo de bytes representa 300 o 738263040 según cómo se interprete. Esa diferencia tan grande es la señal típica de un problema de endianness: si al leer un archivo obtienes números absurdamente grandes donde esperabas valores pequeños, sospecha del orden de bytes.
Para estructuras binarias con varios campos, el módulo struct es la herramienta estándar. El primer carácter de la cadena de formato indica el orden: > para big-endian, < para little-endian, ! para el orden de red, equivalente a big-endian, y = para el nativo:
import struct

print(struct.pack(">I", 0x0A0B0C0D).hex(" "))
print(struct.pack("<I", 0x0A0B0C0D).hex(" "))

cabecera = bytes.fromhex("1f900050")
puerto_origen, puerto_destino = struct.unpack("!HH", cabecera)
print(puerto_origen, puerto_destino)
0a 0b 0c 0d
0d 0c 0b 0a
8080 80
Si omites el prefijo, struct usa el orden nativo y además añade relleno de alineación, lo que hace que los datos no sean portables. Indica siempre el orden de forma explícita cuando los bytes vayan a guardarse o enviarse.
Los números de coma flotante también tienen endianness. El valor 1.0 en formato IEEE 754 de 32 bits es 0x3F800000:
print(struct.pack("<f", 1.0).hex(" "))
00 00 80 3f
Endianness en JavaScript
En el navegador y en Node.js, los datos binarios se manejan con ArrayBuffer. Los arrays tipados, como Uint32Array, usan el orden nativo de la plataforma, lo que permite detectarlo:
const esLittle = new Uint8Array(new Uint32Array([1]).buffer)[0] === 1;
console.log(esLittle ? "little" : "big");
little
Para leer y escribir con un orden concreto se usa DataView, cuyos métodos reciben un parámetro littleEndian. Si se omite, DataView usa big-endian, independientemente de la plataforma:
const buffer = new ArrayBuffer(4);
const vista = new DataView(buffer);

vista.setUint32(0, 0x0a0b0c0d); // big-endian por defecto
console.log(new Uint8Array(buffer));

console.log(vista.getUint32(0, true).toString(16)); // leído como little-endian
Uint8Array(4) [ 10, 11, 12, 13 ]
d0c0b0a
Por eso, para analizar formatos binarios o protocolos, DataView es preferible a los arrays tipados: el resultado no depende de la máquina en la que se ejecute el código.
En Node.js, la clase Buffer ofrece métodos con el orden en el nombre:
const datos = Buffer.from([0x00, 0x00, 0x01, 0x2c]);
console.log(datos.readUInt32BE(0), datos.readUInt32LE(0));
300 738263040
Endianness en archivos y formatos
Muchos formatos de archivo fijan un orden de bytes en su especificación, independiente de la máquina que los crea o los lee:
- PNG y JPEG almacenan sus campos de varios bytes en big-endian.
- BMP, WAV y la mayoría de formatos de Microsoft usan little-endian.
- TIFF admite ambos y lo indica en sus dos primeros bytes:
IIpara little-endian, por Intel, yMMpara big-endian, por Motorola. - Los ejecutables ELF de Linux indican su orden en la cabecera.
- Formatos modernos de serialización como Protocol Buffers definen su propia codificación, que no depende del orden nativo.
Un programa que lee estos formatos debe convertir siempre desde el orden especificado al nativo. Este ejemplo lee el ancho y el alto de una imagen PNG, que están en big-endian a partir del byte 16:
import struct

def dimensiones_png(ruta):
    with open(ruta, "rb") as archivo:
        cabecera = archivo.read(24)
    if cabecera[:8] != b"\x89PNG\r\n\x1a\n":
        raise ValueError("No es un archivo PNG")
    ancho, alto = struct.unpack(">II", cabecera[16:24])
    return ancho, alto
Unicode y la marca de orden de bytes
Las codificaciones de texto que usan unidades de más de un byte, como UTF-16 y UTF-32, también tienen endianness. Para indicarlo, un archivo puede empezar con la marca de orden de bytes, o BOM, el carácter U+FEFF. Al leer los primeros bytes, el programa sabe cómo interpretar el resto: FE FF indica big-endian y FF FE, little-endian.
print("Ñ".encode("utf-16").hex(" "))      # con BOM, orden nativo
print("Ñ".encode("utf-16-be").hex(" "))   # big-endian sin BOM
print("Ñ".encode("utf-16-le").hex(" "))   # little-endian sin BOM
ff fe d1 00
00 d1
d1 00
UTF-8, la codificación dominante en la web, trabaja con unidades de un byte y no tiene problemas de endianness. Aun así, algunos programas, sobre todo en Windows, añaden al principio de los archivos UTF-8 la secuencia EF BB BF, el BOM codificado en UTF-8. No es necesario y a veces causa problemas: un script con BOM puede fallar en la línea del intérprete, y un CSV puede mostrar caracteres extraños en la primera columna. Python permite leer y escribir estos archivos con la codificación utf-8-sig, que gestiona el BOM automáticamente.
Convertir el orden de los bytes
Cuando hay que invertir el orden de un valor, la mayoría de compiladores ofrece funciones intrínsecas que se traducen en una única instrucción del procesador:
#include <stdio.h>
#include <stdint.h>

int main(void) {
    uint32_t valor = 0x0A0B0C0D;
    printf("%08X\n", __builtin_bswap32(valor));
    return 0;
}
0D0C0B0A
En Linux, la cabecera endian.h proporciona funciones con nombres explícitos, como htobe32, be32toh, htole16 o le64toh, que convierten entre el orden del sistema y uno concreto. C++23 añadió std::byteswap, y C++20 std::endian para consultar el orden nativo. En Rust, los enteros tienen métodos como to_be_bytes y from_le_bytes, y en Go el paquete encoding/binary ofrece binary.BigEndian y binary.LittleEndian.
Pero la técnica más portable es no depender del orden nativo en absoluto, construyendo el valor a partir de los bytes con desplazamientos. Este código funciona igual en cualquier arquitectura:
#include <stdint.h>

uint32_t leer_be32(const unsigned char *p) {
    return (uint32_t)p[0] << 24 |
           (uint32_t)p[1] << 16 |
           (uint32_t)p[2] << 8  |
           (uint32_t)p[3];
}
Con los bytes 00 00 01 2C, devuelve 300 en cualquier máquina. En cambio, copiar esos bytes directamente a un uint32_t con memcpy daría 300 en un sistema big-endian y 738263040 en uno little-endian. Los compiladores modernos reconocen este patrón de desplazamientos y lo optimizan a una sola instrucción, así que no hay penalización de rendimiento.
Ver el endianness en un volcado de memoria
Una de las situaciones en las que más se nota el endianness es al inspeccionar datos binarios con herramientas de volcado hexadecimal. Si guardas un entero de 32 bits en un archivo desde un programa que se ejecuta en un equipo little-endian y lo examinas con od, verás los bytes en orden inverso:
import struct

with open("valor.bin", "wb") as archivo:
    archivo.write(struct.pack("=I", 0x0A0B0C0D))
od -A x -t x1 valor.bin
000000 0d 0c 0b 0a
000004
Las herramientas de volcado pueden agrupar los bytes en palabras de dos o cuatro bytes, y en ese caso los interpretan con el orden nativo, lo que puede resultar confuso. Con od -t x4 el mismo archivo se muestra como 0a0b0c0d en una máquina little-endian, porque la herramienta reconstruye el número. Cuando analices datos binarios, mostrar los bytes de uno en uno, con -t x1, es la forma más fiable de ver lo que realmente hay en el archivo.
Los depuradores tienen el mismo comportamiento. En GDB, el comando x/4xb &valor muestra cuatro bytes individuales en el orden de la memoria, mientras que x/1xw &valor muestra una palabra de 32 bits ya interpretada. Saber cuál de las dos vistas estás mirando evita conclusiones erróneas al depurar estructuras binarias, protocolos o corrupciones de memoria.
Errores comunes relacionados con el endianness
El primero es escribir estructuras de C directamente en un archivo o en un socket con fwrite o send. Además del endianness, el compilador puede añadir bytes de relleno entre campos. El archivo resultante solo podrá leerse en la misma arquitectura y con el mismo compilador. Serializa cada campo de forma explícita.
El segundo es olvidar htons o htonl al configurar sockets, lo que provoca que el programa escuche en un puerto o se conecte a una dirección inesperados.
El tercero es convertir dos veces. Si un valor ya está en orden de red y vuelves a aplicar htonl, en un sistema little-endian quedará de nuevo en orden nativo, y el error solo se manifestará en ciertas plataformas.
El cuarto es usar arrays tipados de JavaScript o struct sin prefijo en Python para formatos que tienen un orden definido. Funcionará en tu máquina, pero no en otra con distinto endianness.
El quinto es confundir endianness con el orden de los bits. El endianness casi siempre se refiere a bytes. El orden de los bits dentro de un byte solo importa en contextos muy concretos, como ciertos protocolos serie o campos de bits en estructuras.
Y el sexto es suponer que todo el mundo es little-endian. Aunque es lo más habitual, el código que se ejecuta en mainframes, en algunos sistemas embebidos o que procesa formatos de red y archivos debe tener en cuenta el orden. Escribir código explícito sobre el orden de los bytes cuesta poco y evita errores muy difíciles de depurar.
Conclusiones
El endianness es el orden en el que se guardan en memoria los bytes de un valor que ocupa más de uno. En big-endian, el byte más significativo va primero, en la misma posición en que escribimos los números; en little-endian, va primero el menos significativo. Afecta solo al orden de los bytes, no al de los bits dentro de cada uno, y no tiene ningún efecto sobre los valores de un solo byte.
Los procesadores actuales más extendidos, x86-64, ARM en sus usos habituales y RISC-V, son little-endian, mientras que big-endian sigue siendo el estándar de los protocolos de red, el llamado orden de bytes de red, de muchos formatos de archivo y de plataformas como los mainframes de IBM.
En la práctica, el endianness importa cuando los datos salen de la memoria del programa: al enviarlos por la red, al guardarlos en archivos binarios o al intercambiarlos entre plataformas. Las herramientas para manejarlo están en todos los lenguajes: htonl y ntohl en C, to_bytes, from_bytes y struct en Python, DataView y Buffer en JavaScript, y funciones de inversión de bytes en casi cualquier compilador.
La regla de oro es no depender nunca del orden nativo cuando los datos vayan a compartirse: especifica siempre el orden de forma explícita o construye los valores con desplazamientos. Con esa disciplina, el código funcionará correctamente en cualquier arquitectura.