Extraccion de subcadenas con slicing
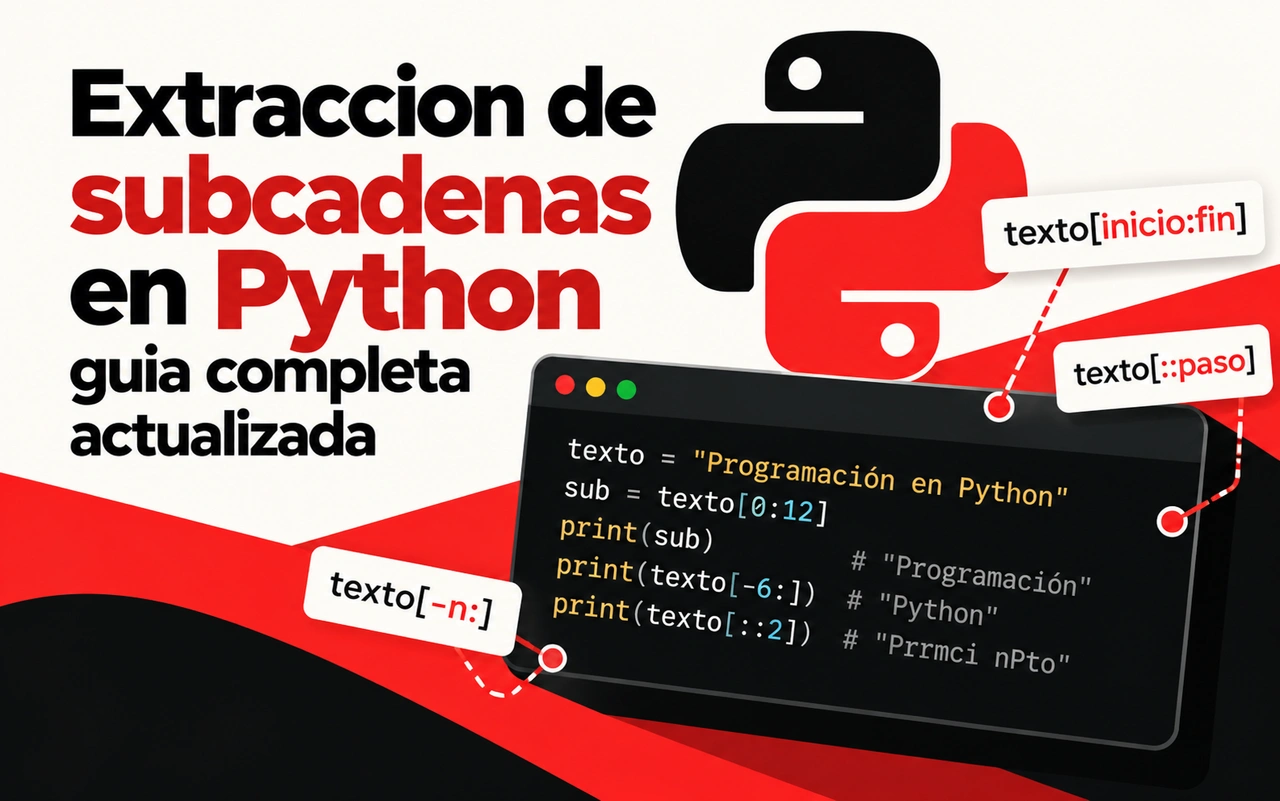
En Python las cadenas son secuencias inmutables de caracteres Unicode. Una de las formas mas directas y eficientes de obtener un fragmento es mediante el slicing, que utiliza la notacion de corchetes con uno o dos puntos. La sintaxis general es cadena[inicio:fin:paso], donde inicio es el indice del primer caracter incluido, fin es el indice del primer caracter excluido y paso indica el incremento entre caracteres consecutivos. Cuando se omiten los valores, el inicio toma el valor cero, el fin toma la longitud de la cadena y el paso toma el valor uno.
El slicing resulta especialmente util cuando se conocen de antemano las posiciones de los caracteres deseados. Por ejemplo, para extraer los cuatro primeros caracteres de una cadena de identificacion se puede escribir identificador[:4]. Si se necesita el fragmento que comienza en el indice 5 y llega hasta el final, se utiliza identificador[5:]. La combinacion de ambos limites permite seleccionar rangos intermedios con precision. Es importante recordar que el indice final es exclusivo, lo que evita errores de off-by-one cuando se calculan longitudes de forma explicita.
Los indices negativos permiten contar desde el final de la cadena. El valor -1 corresponde al ultimo caracter, -2 al penultimo y asi sucesivamente. Esta caracteristica facilita la extraccion de sufijos sin necesidad de calcular la longitud previamente. Una expresion como cadena[-5:] devuelve los ultimos cinco caracteres, mientras que cadena[:-3] elimina los tres ultimos. Cuando se combina un paso negativo, el slicing invierte el orden de los caracteres, lo que permite obtener la cadena al reves con la expresion cadena[::-1].
El manejo de limites fuera de rango es tolerante. Si el indice de inicio es mayor que la longitud, el resultado es una cadena vacia. Si el indice de fin supera la longitud, se toma hasta el final. Esta conducta evita excepciones y simplifica el codigo cuando los limites se calculan de forma dinamica. Para casos en los que se desea un comportamiento mas estricto, se puede validar previamente con la funcion len o capturar posibles errores en un contexto controlado.
texto = "Extraccion de subcadenas en Python"
fragmento = texto[12:22]
print(fragmento)
# Resultado: subcadena
El slicing crea una nueva cadena, por lo que no modifica el original. Esta inmutabilidad garantiza que las operaciones no produzcan efectos secundarios inesperados cuando se pasan cadenas a funciones. En terminos de rendimiento, el slicing de un rango continuo es una operacion eficiente que copia solo los caracteres necesarios.
Medir la longitud de una subcadena
Una vez obtenido un fragmento, es frecuente necesitar conocer cuantos caracteres contiene. La funcion incorporada len recibe cualquier secuencia y devuelve su numero de elementos. Aplicada a una subcadena, len proporciona un entero que puede utilizarse para validaciones, para calcular indices posteriores o para formatear salidas.
La combinacion de slicing y len resulta util cuando se procesan campos de longitud fija, como codigos de producto o fechas en formato compacto. Por ejemplo, despues de extraer un codigo de cuatro caracteres se puede verificar que len(codigo) == 4 antes de continuar con el procesamiento. Si la longitud no coincide, se puede registrar un error o aplicar una correccion.
cadena = "Hola Mundo"
sub = cadena[0:4]
print(len(sub))
# Resultado: 4
La funcion len tambien se emplea para calcular el punto medio de una cadena o para limitar el numero de caracteres que se muestran en interfaces de usuario. Cuando se trabaja con textos muy largos, obtener la longitud de una subcadena extraida evita recorrer toda la cadena original en operaciones posteriores.
Busqueda de subcadenas en cadenas
Cuando las posiciones no se conocen de antemano, los metodos de busqueda permiten localizar la primera o la ultima aparicion de un fragmento. El metodo find devuelve el indice de la primera ocurrencia o el valor -1 si la subcadena no esta presente. Esta convencion facilita las comprobaciones condicionales sin necesidad de capturar excepciones.
El metodo index realiza la misma busqueda, pero genera una excepcion ValueError cuando no encuentra la subcadena. Se prefiere index cuando la presencia del fragmento es una precondicion del algoritmo y se desea que el error se propague de forma explicita. Ambos metodos aceptan argumentos opcionales de inicio y fin que restringen el rango de busqueda, lo que resulta util para localizar ocurrencias sucesivas.
texto = "Extraccion de subcadenas en Python"
posicion = texto.find("subcadenas")
print(posicion)
# Resultado: 12
Para buscar desde el final se utilizan rfind y rindex. Estas variantes son especialmente utiles cuando se procesan rutas de archivos o direcciones de correo electronico, donde el ultimo delimitador determina el componente relevante. La combinacion de find con slicing permite extraer el texto que sigue a un marcador conocido sin recorrer la cadena manualmente.
El operador in ofrece una forma concisa de comprobar la existencia de una subcadena sin obtener su posicion. La expresion if “error” in registro: es legible y eficiente para la mayoria de los casos de validacion. Cuando se necesita tanto la presencia como la posicion, find sigue siendo la opcion mas directa.
Reemplazo de subcadenas
El metodo replace genera una nueva cadena en la que todas las ocurrencias de un fragmento se sustituyen por otro. El metodo no modifica la cadena original, lo que mantiene la inmutabilidad. Se puede limitar el numero de reemplazos mediante un tercer argumento opcional, lo que resulta util cuando solo se desea corregir la primera aparicion de un error tipografico o de un token.
texto = "Python es divertido y Python es potente"
nuevo = texto.replace("Python", "Python 3", 1)
print(nuevo)
Cuando se desea eliminar un fragmento, se reemplaza por la cadena vacia. Esta tecnica es comun en tareas de limpieza de datos, como la eliminacion de comas, espacios extra o caracteres de control. Para reemplazos mas complejos que involucran patrones variables, el modulo re ofrece la funcion sub, que acepta expresiones regulares y funciones de reemplazo.
El metodo replace es eficiente para sustituciones literales. Cuando el numero de ocurrencias es elevado o el texto es muy largo, puede resultar conveniente procesar la cadena por partes o utilizar herramientas especializadas de procesamiento de texto. En la mayoria de las aplicaciones cotidianas, sin embargo, replace cubre las necesidades de transformacion de forma clara y directa.
Division de una cadena en subcadenas
El metodo split divide una cadena en una lista de subcadenas utilizando un separador. Cuando se invoca sin argumentos, split trata cualquier secuencia de espacios en blanco como delimitador y descarta los espacios vacios resultantes. Esta conducta resulta conveniente para tokenizar texto libre.
Si se proporciona un separador explicito, split respeta las ocurrencias consecutivas y puede generar cadenas vacias. El parametro maxsplit limita el numero de divisiones, lo que permite separar solo el primer campo y dejar el resto intacto. Esta opcion es util al procesar lineas de registro donde solo interesa el timestamp inicial.
linea = "2026-10-11 21:20:00 INFO Usuario autenticado"
partes = linea.split(maxsplit=2)
print(partes)
El metodo partition divide la cadena en una tupla de tres elementos: el texto anterior al separador, el separador mismo y el texto posterior. A diferencia de split, partition siempre devuelve exactamente tres elementos, incluso cuando el separador no esta presente. Esta garantia simplifica el codigo que espera una estructura fija.
Para divisiones basadas en patrones complejos, el modulo re proporciona re.split, que acepta expresiones regulares como separadores. Esta capacidad permite, por ejemplo, dividir por cualquier combinacion de comas y espacios o por secuencias de digitos. La eleccion entre split nativo y re.split depende de la complejidad del delimitador y de los requisitos de rendimiento.
Unificacion de subcadenas
Una vez que se dispone de una lista de fragmentos, el metodo join permite recombinarlos en una sola cadena utilizando un separador. La llamada se realiza sobre el separador, no sobre la lista: separador.join(lista). Esta inversion puede resultar sorprendente al principio, pero permite que cualquier cadena actue como separador, incluyendo cadenas vacias, saltos de linea o secuencias de varios caracteres.
palabras = ["Extraccion", "de", "subcadenas"]
resultado = " ".join(palabras)
print(resultado)
join es la forma recomendada de construir cadenas a partir de multiples fragmentos, ya que evita la creacion de objetos intermedios que se producen con la concatenacion repetida mediante el operador +. Cuando el numero de elementos es elevado, la diferencia de rendimiento es significativa. Para casos en los que se necesita un formato mas elaborado, se pueden combinar comprensiones de listas con join o utilizar el metodo format y las f-strings.
La flexibilidad de join permite generar salidas en formatos CSV, rutas de sistema o mensajes multilinea con un minimo de codigo. Al elegir el separador se debe considerar si los elementos pueden contener ese mismo caracter, en cuyo caso puede ser necesario escapar o utilizar un formato estructurado diferente.
Eliminacion de subcadenas
La eliminacion de un fragmento se realiza habitualmente mediante replace con una cadena vacia como segundo argumento. Esta tecnica elimina todas las ocurrencias del fragmento indicado. Cuando solo se desea eliminar la primera aparicion, se puede limitar el numero de reemplazos o combinar find con slicing para reconstruir la cadena sin el segmento no deseado.
texto = "Hola, mundo!"
limpio = texto.replace(", ", "")
print(limpio)
Para eliminaciones mas selectivas, como la supresion de etiquetas HTML o de comentarios, resulta mas adecuado el modulo re con patrones que identifiquen el contenido a remover. En tareas de normalizacion de texto, es comun encadenar varias llamadas a replace o utilizar translate para eliminar conjuntos de caracteres de forma eficiente.
La inmutabilidad de las cadenas implica que cada eliminacion produce un nuevo objeto. En bucles que procesan grandes volumenes de texto, puede ser preferible acumular los fragmentos deseados en una lista y unirlos al final, en lugar de realizar reemplazos sucesivos sobre la misma cadena.
Validar inicio o fin de una subcadena
Los metodos startswith y endswith comprueban si una cadena comienza o termina con un fragmento determinado. Ambos aceptan una tupla de posibles prefijos o sufijos, lo que permite verificar varias alternativas en una sola llamada. Tambien aceptan argumentos de inicio y fin que restringen la comprobacion a un rango de la cadena.
archivo = "informe_final.pdf"
if archivo.endswith((".pdf", ".docx")):
    print("Formato de documento reconocido")
Estas validaciones son frecuentes al procesar nombres de archivo, cabeceras de protocolos o entradas de usuario. Su implementacion es eficiente y su lectura es inmediata, por lo que se prefieren frente a comparaciones manuales de slicing cuando solo interesa el extremo de la cadena.
Cuando la comprobacion debe ignorar diferencias de mayusculas y minusculas, se puede normalizar previamente con lower o casefold. casefold es la opcion recomendada para comparaciones insensibles a mayusculas en textos internacionales, ya que maneja correctamente ciertos caracteres Unicode que lower no transforma de la misma manera.
Conversion a mayusculas y minusculas
Los metodos upper y lower generan nuevas cadenas con todos los caracteres en mayusculas o minusculas respectivamente. Estos metodos resultan utiles para normalizar texto antes de realizar comparaciones o de almacenar valores en bases de datos que no distinguen mayusculas. El metodo capitalize convierte solo el primer caracter a mayuscula y el resto a minuscula, mientras que title capitaliza la primera letra de cada palabra.
nombre = "python"
print(nombre.upper())
print(nombre.capitalize())
Para textos que contienen caracteres no ASCII, casefold ofrece una normalizacion mas agresiva que lower. Esta diferencia es relevante cuando se procesan nombres propios o terminos tecnicos en multiples idiomas. La combinacion de estos metodos con slicing permite transformar solo una porcion de la cadena, por ejemplo capitalizando un codigo de producto mientras se mantiene el resto en minusculas.
En flujos de limpieza de datos es habitual aplicar lower o casefold al inicio del procesamiento para garantizar que las busquedas y las comparaciones posteriores sean consistentes. Esta normalizacion temprana reduce la complejidad de las condiciones posteriores y evita errores sutiles relacionados con la capitalizacion.
Comparacion entre subcadenas
Las cadenas se comparan mediante los operadores habituales de igualdad y orden. La comparacion es sensible a mayusculas por defecto, por lo que “Python” y “python” se consideran distintas. Para realizar comparaciones insensibles a mayusculas se normalizan ambos lados con lower o casefold antes de aplicar el operador.
a = "Hola"
b = "hola"
print(a.lower() == b.lower())
El orden lexicografico sigue el orden de los puntos de codigo Unicode. Esta propiedad permite ordenar listas de cadenas de forma natural, aunque para ordenaciones que respeten las reglas de un idioma concreto es preferible utilizar la libreria locale o bibliotecas especializadas. Cuando se comparan subcadenas extraidas mediante slicing, se debe tener en cuenta que los indices negativos y los pasos pueden producir resultados inesperados si no se validan previamente.
Las comparaciones tambien se utilizan para implementar logica de validacion, como comprobar que un codigo de verificacion coincide con un valor esperado o que un fragmento de texto cumple un formato determinado. En estos casos, la combinacion de slicing, normalizacion y comparacion directa produce codigo claro y facil de mantener.
Tecnicas avanzadas y casos de uso
Cuando los patrones de extraccion son variables, el modulo re permite definir expresiones regulares que capturan grupos especificos. La funcion search localiza la primera coincidencia y group extrae el texto capturado. Para encontrar todas las ocurrencias se utiliza findall o finditer. Estas herramientas son indispensables al procesar registros de servidor, documentos estructurados o entradas de usuario con formatos flexibles.
import re
texto = "El codigo es ABC-1234 y la fecha es 2026-10-11"
codigo = re.search(r"[A-Z]{3}-\d{4}", texto)
if codigo:
    print(codigo.group())
En el procesamiento de archivos CSV o de lineas de configuracion, la combinacion de split, strip y slicing permite extraer campos con un minimo de dependencias. Para formatos mas complejos, como JSON o XML, es preferible utilizar los modulos estandar correspondientes en lugar de manipular las cadenas manualmente.
Las cadenas inmutables implican que cada operacion de slicing o de reemplazo crea un nuevo objeto. En bucles que construyen textos largos, la practica recomendada es acumular los fragmentos en una lista y unirlos al final con join. Esta tecnica reduce la complejidad temporal y evita la creacion excesiva de objetos intermedios.
Los casos limite merecen atencion especial. Una cadena vacia produce resultados vacios en la mayoria de las operaciones de slicing y de busqueda. Los indices fuera de rango en slicing no generan excepciones, pero pueden ocultar errores de logica si no se validan. Cuando se trabaja con texto Unicode, es importante recordar que algunos caracteres ocupan mas de un punto de codigo, aunque para la mayoria de las operaciones de slicing el comportamiento es el esperado a nivel de caracteres.
Conclusiones
La extraccion y manipulacion de subcadenas constituye una habilidad fundamental en el desarrollo con Python. El slicing ofrece una forma concisa y eficiente de obtener fragmentos cuando se conocen las posiciones, mientras que los metodos find, split, replace, join, startswith y endswith cubren la mayoria de las necesidades de busqueda, division, transformacion y validacion. La combinacion de estas herramientas permite resolver desde tareas sencillas de limpieza de texto hasta procesamientos mas elaborados de registros y formatos estructurados.
El conocimiento de la inmutabilidad de las cadenas, de los indices negativos y de las opciones avanzadas como el paso en el slicing o los argumentos de rango en los metodos de busqueda contribuye a escribir codigo mas robusto y legible. Cuando los patrones superan las capacidades de los metodos basicos, el modulo de expresiones regulares proporciona la flexibilidad necesaria sin abandonar la biblioteca estandar.
Dominar estas tecnicas facilita el analisis de texto, la validacion de entradas y la transformacion de datos en una amplia variedad de aplicaciones. La practica continua con ejemplos reales y la atencion a los casos limite permiten aplicar estas herramientas de forma efectiva y mantener la claridad del codigo a medida que los requisitos evolucionan.