Introduccion al procesamiento de datos textuales con TF-IDF
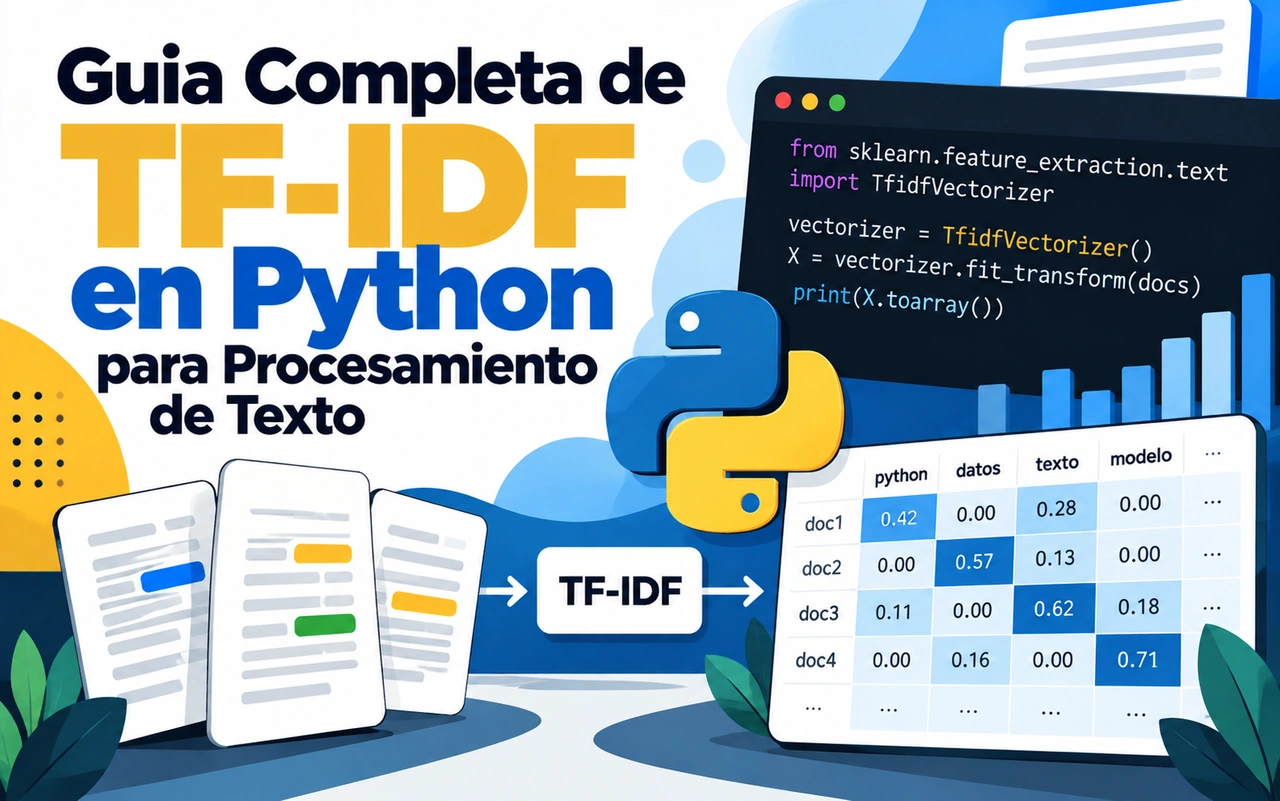
Los ordenadores manejan numeros con facilidad, pero el texto natural presenta un desafio mayor. Las palabras, frases y documentos deben convertirse en representaciones numericas antes de poder aplicar algoritmos de aprendizaje automatico o tecnicas de recuperacion de informacion. Una de las tecnicas clasicas y todavia muy utilizadas en 2026 para este proposito es TF-IDF, que significa frecuencia de terminos por frecuencia inversa de documentos.
La intuicion basica es sencilla. Las palabras que aparecen con mucha frecuencia en un documento podrian parecer importantes, pero en la practica muchas de ellas son palabras vacias como articulos, preposiciones o verbos auxiliares que aportan poca informacion distintiva. En cambio, los terminos que aparecen a menudo en un documento concreto pero son raros en el resto del corpus suelen ser los mas informativos. TF-IDF formaliza esta idea y asigna un peso a cada termino en cada documento.
En entornos de produccion actuales, TF-IDF sigue siendo una base solida para tareas de clasificacion de texto, filtrado de spam, analisis de sentimiento basico, recuperacion de informacion lexica y deteccion de anomalias en registros. Aunque los modelos basados en transformadores y embeddings densos han avanzado mucho, TF-IDF ofrece transparencia, velocidad y buenos resultados cuando la coincidencia de terminos es el factor clave. Esta guia explica el fundamento matematico, la implementacion manual, el uso de scikit-learn y las practicas recomendadas para integrarlo en pipelines modernos.
Fundamentos matematicos de TF y IDF
La frecuencia de terminos (TF) mide cuan a menudo aparece un termino dentro de un documento especifico. Una formula comun es el numero de veces que aparece el termino dividido entre el total de terminos del documento:
[ \mathrm{tf}(t, d) = \frac{\mathrm{count}(t, d)}{|d|} ]
Cada documento tiene su propio vector de frecuencias de terminos. Un termino que se repite muchas veces en un documento largo obtiene un valor mayor, aunque existen variantes que suavizan este efecto.
La frecuencia inversa de documentos (IDF) penaliza los terminos que aparecen en muchos documentos del corpus. La formula clasica es:
[ \mathrm{idf}(t) = \log\left(\frac{N}{\mathrm{df}(t)}\right) ]
donde (N) es el numero total de documentos y (\mathrm{df}(t)) es el numero de documentos que contienen el termino (t). Los terminos raros obtienen un IDF alto, mientras que los terminos presentes en casi todos los documentos obtienen un IDF cercano a cero.
El peso TF-IDF final de un termino en un documento es el producto de ambas magnitudes:
[ w(t, d) = \mathrm{tf}(t, d) \times \mathrm{idf}(t) ]
Consideremos un corpus pequeno formado por dos documentos. El primero dice “El coche circula por la carretera”. El segundo dice “El camion circula por la autopista”. Tras eliminar o ignorar palabras muy comunes, los terminos “coche”, “camion”, “carretera” y “autopista” reciben pesos positivos, mientras que terminos compartidos como “circula” o “por” reciben pesos bajos o nulos. Esta diferencia permite distinguir documentos que de otro modo parecerian similares.
En la practica, las implementaciones modernas aplican suavizado para evitar divisiones por cero y valores extremos. Una version habitual es:
[ \mathrm{idf}(t) = \log\left(\frac{1 + N}{1 + \mathrm{df}(t)}\right) + 1 ]
Este ajuste mantiene un peso minimo incluso para terminos muy frecuentes y mejora la estabilidad numerica.
Implementacion desde cero en Python
Para comprender el mecanismo es util calcular TF-IDF sin bibliotecas especializadas. Primero se tokeniza el texto y se construye un diccionario de conteos por documento. Una funcion sencilla para la frecuencia de terminos puede escribirse asi:
def compute_tf(word_counts, total_words):
    tf_dict = {}
    for word, count in word_counts.items():
        tf_dict[word] = count / float(total_words)
    return tf_dict
A continuacion se calcula el IDF recorriendo todos los documentos y contando en cuantos aparece cada termino:
import math

def compute_idf(documents):
    n = len(documents)
    idf_dict = {}
    for doc in documents:
        for word in doc:
            idf_dict[word] = idf_dict.get(word, 0) + 1
    for word in idf_dict:
        idf_dict[word] = math.log(n / float(idf_dict[word]))
    return idf_dict
Finalmente se multiplican ambos valores:
def compute_tfidf(tf_dict, idf_dict):
    tfidf = {}
    for word, tf in tf_dict.items():
        tfidf[word] = tf * idf_dict.get(word, 0.0)
    return tfidf
Con un corpus de ejemplo se puede verificar que los terminos distintivos reciben valores mayores. Esta implementacion ilustra el concepto, pero no gestiona tokenizacion avanzada, normalizacion ni matrices dispersas. Para corpus reales es preferible utilizar una biblioteca optimizada.
Uso de TfidfVectorizer de scikit-learn
scikit-learn proporciona la clase TfidfVectorizer, que combina tokenizacion, construccion de vocabulario, calculo de IDF y normalizacion en una interfaz compacta. El uso basico es directo:
from sklearn.feature_extraction.text import TfidfVectorizer

documentos = [
    "El coche circula por la carretera.",
    "El camion circula por la autopista."
]
vectorizer = TfidfVectorizer()
matriz = vectorizer.fit_transform(documentos)
print(vectorizer.get_feature_names_out())
print(matriz.toarray().round(3))
El metodo fit_transform aprende el vocabulario y los pesos IDF a partir del corpus y transforma los documentos en una matriz dispersa. Por defecto se aplica normalizacion L2, lo que facilita el uso posterior de similitud coseno. La version de scikit-learn disponible en 2026 (alrededor de la 1.9) mantiene esta interfaz estable y anade mejoras de rendimiento y de manejo de tipos de datos.
Es importante ajustar el vectorizador solo sobre los datos de entrenamiento y luego aplicar transform sobre los datos de validacion o prueba. De lo contrario se produce fuga de informacion y las columnas dejan de ser comparables.
X_train = vectorizer.fit_transform(documentos_entrenamiento)
X_test = vectorizer.transform(documentos_prueba)
La matriz resultante es dispersa, lo que resulta esencial cuando el vocabulario supera las decenas de miles de terminos. Convertirla a formato denso puede agotar la memoria en corpus grandes.
Parametros avanzados y mejores practicas en 2026
TfidfVectorizer expone numerosos parametros que permiten adaptar el comportamiento al dominio. Entre los mas utiles se encuentran ngram_range, min_df, max_df, sublinear_tf y stop_words.
El parametro ngram_range=(1, 2) incluye unigramas y bigramas, capturando frases como “cambio climatico” o “fallo de pago” que un solo token no representa. El coste es un vocabulario mayor.
min_df elimina terminos que aparecen en muy pocos documentos y suele fijarse en 2 o 3 para reducir ruido de erratas. max_df elimina terminos presentes en casi todos los documentos y actua como un filtro automatico de palabras vacias especificas del corpus; un valor tipico es 0.95.
sublinear_tf=True reemplaza la frecuencia cruda por 1 + log(tf), lo que reduce el efecto de repeticiones excesivas dentro de un mismo documento. Esta opcion mejora resultados en textos largos o repetitivos.
vectorizer = TfidfVectorizer(
    lowercase=True,
    stop_words="english",
    ngram_range=(1, 2),
    min_df=2,
    max_df=0.95,
    sublinear_tf=True,
    max_features=50000
)
En 2026 se recomienda comenzar con unigramas y bigramas, suavizado de IDF activado por defecto y normalizacion L2. Para textos ruidosos o con variaciones ortograficas puede resultar util el analizador de caracteres. Siempre se debe guardar el vectorizador ajustado y reutilizarlo exactamente igual en inferencia para garantizar que el vocabulario y los pesos IDF permanezcan alineados.
Integracion en pipelines de aprendizaje automatico
La forma mas segura de utilizar TF-IDF dentro de un flujo de aprendizaje automatico es encapsularlo en un Pipeline de scikit-learn. Esto garantiza que el ajuste del vectorizador ocurra solo dentro de cada pliegue de validacion cruzada y evita fugas.
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score

pipeline = Pipeline([
    ("tfidf", TfidfVectorizer(ngram_range=(1, 2), min_df=2, sublinear_tf=True)),
    ("clasificador", LogisticRegression(max_iter=1000, class_weight="balanced"))
])
Un pipeline de este tipo se entrena y evalua de forma correcta. Los modelos lineales como LogisticRegression o LinearSVC suelen obtener buenos resultados con caracteristicas TF-IDF porque el espacio es de alta dimension y disperso. En muchas tareas de clasificacion de documentos de longitud media, esta combinacion alcanza precisiones competitivas sin necesidad de GPU ni de modelos de gran tamano.
Cuando el corpus es muy grande se puede limitar el numero de caracteristicas con max_features o utilizar HashingVectorizer seguido de TfidfTransformer para controlar el consumo de memoria. En ambos casos la matriz permanece dispersa hasta que el estimador lo requiera.
Comparacion con embeddings y modelos modernos
TF-IDF representa documentos mediante estadisticas de co-ocurrencia de terminos y no captura sinonimia ni contexto profundo. Un embedding de oraciones producido por un modelo de transformadores codifica significado semantico y puede identificar que dos frases con palabras distintas expresan la misma idea.
En 2026 la recomendacion practica es comenzar con TF-IDF como linea base rapida e interpretable. Si la tarea depende de coincidencia lexica exacta, de terminos tecnicos o de velocidad de inferencia, TF-IDF sigue siendo preferible. Cuando se necesita generalizacion semantica, deteccion de parafrasis o busqueda semantica, se recurre a embeddings densos o a modelos de lenguaje finetuneados.
Muchos sistemas de produccion combinan ambos enfoques: una primera etapa de recuperacion dispersa con TF-IDF o BM25 seguida de un reranking con embeddings. Esta arquitectura hibrida aprovecha la precision de los terminos y la capacidad semantica de los modelos neurales.
Ejemplos practicos de clasificacion de texto
Un caso tipico es la clasificacion de correos electronicos o de tickets de soporte. Tras limpiar el texto se ajusta el vectorizador solo sobre el conjunto de entrenamiento y se entrena un clasificador lineal. Los coeficientes del modelo lineal indican que terminos impulsan cada clase, lo que facilita la interpretacion.
Otro escenario es la deteccion de anomalias en registros de aplicacion. Los mensajes de error que contienen terminos raros reciben pesos altos y pueden agruparse o filtrarse mediante similitud coseno. Dado que la normalizacion L2 esta activada por defecto, la similitud coseno se reduce a un producto escalar.
Para busqueda simple se puede transformar una consulta con el mismo vectorizador y recuperar los documentos con mayor similitud. Este enfoque funciona bien cuando las consultas y los documentos comparten vocabulario especifico.
Errores comunes y como evitarlos
Un error frecuente consiste en llamar a fit_transform de forma independiente sobre el conjunto de prueba. Esto genera un vocabulario distinto y pesos IDF diferentes, de modo que las columnas dejan de corresponder. La solucion es ajustar una sola vez y transformar despues.
Otro problema aparece cuando se convierten matrices grandes a formato denso sin necesidad. El consumo de memoria crece de forma cuadratica con el vocabulario. Se debe mantener la representacion dispersa el mayor tiempo posible.
La falta de preprocesamiento tambien degrada los resultados. Convertir a minusculas, eliminar puntuacion irrelevante y decidir si se conservan o eliminan palabras vacias segun la tarea (por ejemplo, en analisis de sentimiento las negaciones suelen ser importantes) mejora la calidad de las caracteristicas.
Finalmente, no guardar el vectorizador ajustado provoca inconsistencias entre entrenamiento e inferencia. El objeto serializado debe incluir el vocabulario, los pesos IDF y todos los parametros de tokenizacion.
Conclusiones
TF-IDF sigue siendo una herramienta fundamental para convertir texto en caracteristicas numericas interpretables y eficientes. Comprender su fundamento matematico, implementarlo de forma manual para fijar conceptos y luego utilizar TfidfVectorizer de scikit-learn con parametros adecuados permite construir pipelines robustos. En 2026 la practica recomendada consiste en ajustar el vectorizador unicamente sobre datos de entrenamiento, encapsularlo en un Pipeline, emplear n-gramas y filtros de frecuencia de documentos, y combinarlo con modelos lineales como linea base. Cuando la tarea requiere comprension semantica profunda se complementa o se sustituye por embeddings, pero en muchos escenarios de produccion la transparencia y la velocidad de TF-IDF continuan aportando valor. La experimentacion sistematica con estos parametros y la validacion correcta de los flujos de datos conducen a sistemas de procesamiento de texto fiables y mantenibles.