Introduccion al web scraping de IMDb
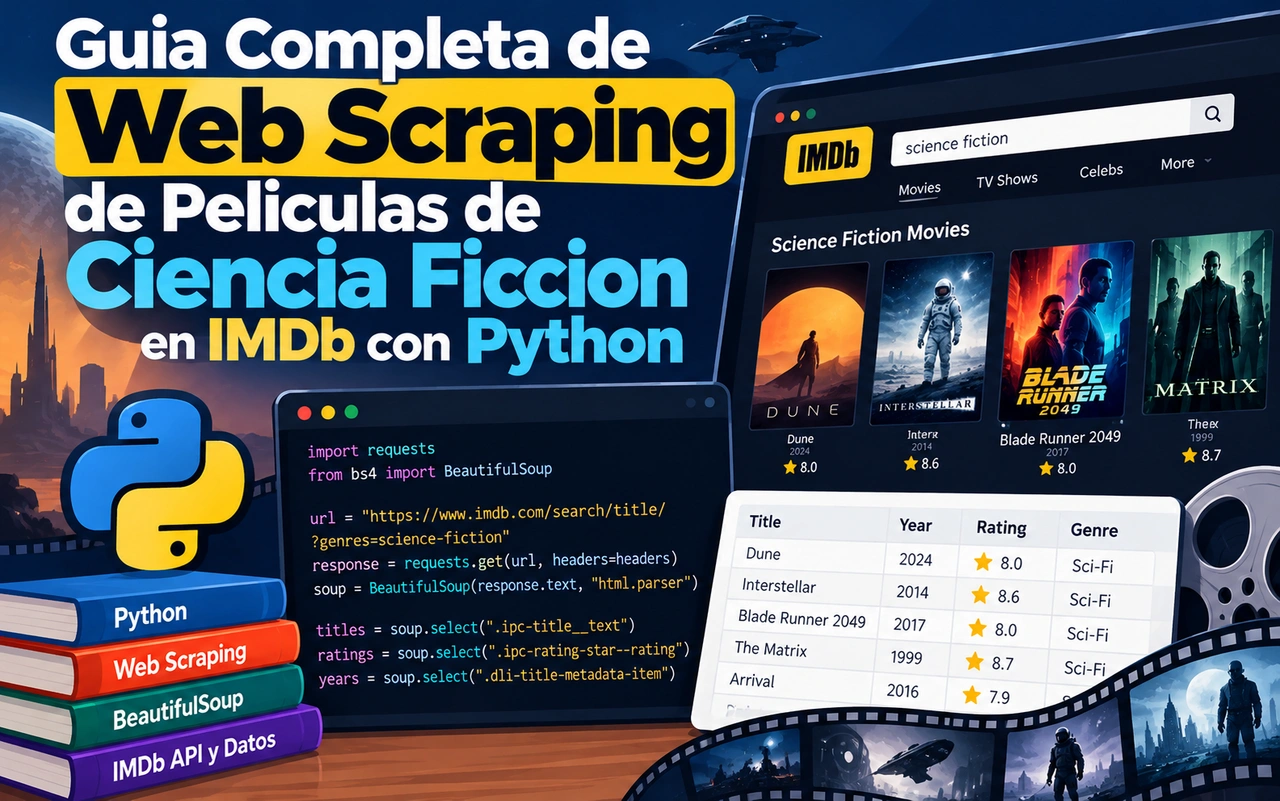
El web scraping permite extraer informacion estructurada de paginas web de forma automatica. En este caso se obtienen datos de peliculas de ciencia ficcion listadas en IMDb, incluyendo titulo, ano, calificacion y otros campos relevantes. Se utiliza Python junto con las bibliotecas requests para realizar las peticiones HTTP y BeautifulSoup para analizar el HTML y localizar los elementos deseados.
IMDb presenta las peliculas en listas paginadas. Un scraper debe recorrer multiples paginas, extraer la informacion de cada pelicula y consolidar los resultados. El proceso incluye el manejo de encabezados para simular un navegador, la espera entre peticiones para reducir la carga al servidor y la limpieza de los datos extraidos. En 2026 las tecnicas basicas de scraping con BeautifulSoup siguen siendo efectivas para sitios que sirven HTML estatico o semiestatico, aunque se recomienda respetar los terminos de uso y los archivos robots.txt.
Esta guia describe el flujo completo: preparacion del entorno, inspeccion de la estructura de la pagina, extraccion de datos, manejo de la paginacion, almacenamiento y consideraciones practicas. El objetivo es obtener un archivo CSV con la informacion de las peliculas de ciencia ficcion.
Preparacion del entorno y dependencias
Se recomienda trabajar dentro de un entorno virtual para aislar las dependencias. Las bibliotecas principales son requests y beautifulsoup4. Opcionalmente se puede utilizar pandas para facilitar la manipulacion y el almacenamiento de los datos.
python -m venv venv
source venv/bin/activate
pip install requests beautifulsoup4 pandas
Una vez instaladas las dependencias se puede comenzar a explorar la pagina objetivo. La URL base de la lista de peliculas de ciencia ficcion en IMDb sigue un patron que incluye parametros de paginacion. Es importante identificar los selectores CSS o las etiquetas que contienen el titulo, el ano, la calificacion y el enlace de cada pelicula.
Inspeccion de la estructura de la pagina
Al abrir la pagina de resultados de IMDb en un navegador se utiliza la herramienta de inspeccion para localizar los contenedores de cada pelicula. Habitualmente cada elemento se encuentra dentro de un contenedor con una clase especifica. Dentro de ese contenedor aparecen el titulo en una etiqueta de encabezado o enlace, el ano en un elemento de texto y la calificacion en un span o div dedicado.
Los selectores pueden cambiar con el tiempo, por lo que conviene verificarlos antes de ejecutar el scraper de forma masiva. Una vez identificados los selectores se construye una funcion que recibe el HTML de una pagina y devuelve una lista de diccionarios con los datos de las peliculas encontradas.
import requests
from bs4 import BeautifulSoup

def extraer_peliculas(html):
    sopa = BeautifulSoup(html, "html.parser")
    peliculas = []
    for contenedor in sopa.select("div.lister-item"):
        titulo = contenedor.select_one("h3 a").get_text(strip=True)
        ano = contenedor.select_one("span.lister-item-year").get_text(strip=True)
        calificacion = contenedor.select_one("div.ratings-imdb-rating")
        calificacion = calificacion.get_text(strip=True) if calificacion else "N/A"
        peliculas.append({
            "titulo": titulo,
            "ano": ano,
            "calificacion": calificacion
        })
    return peliculas
Realizacion de peticiones y manejo de encabezados
Para evitar bloqueos es recomendable incluir un encabezado User-Agent que simule un navegador real. Tambien se puede anadir un tiempo de espera entre peticiones. La funcion principal recorre las paginas utilizando el parametro start o el equivalente que utilice IMDb en el momento de la ejecucion.
import time

def obtener_pagina(url, headers):
    respuesta = requests.get(url, headers=headers)
    respuesta.raise_for_status()
    return respuesta.text

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}
Se construye un bucle que incrementa el offset de paginacion hasta que no se encuentren mas resultados o se alcance un limite predefinido. Cada pagina se procesa con la funcion de extraccion y los resultados se acumulan en una lista.
Limpieza y normalizacion de datos
Los datos extraidos suelen contener caracteres adicionales, espacios o formatos inconsistentes. El ano puede aparecer entre parentesis y la calificacion puede incluir texto extra. Se aplican operaciones de limpieza para dejar los valores en un formato uniforme.
def limpiar_ano(texto):
    return texto.strip("()")

def limpiar_calificacion(texto):
    return texto.split()[0] if texto != "N/A" else None
Despues de la limpieza se puede convertir la lista de diccionarios en un DataFrame de pandas para facilitar el filtrado, el ordenamiento y la exportacion.
Almacenamiento de resultados
Los resultados se guardan en un archivo CSV que puede abrirse con cualquier hoja de calculo o procesarse posteriormente con pandas. Se especifica la codificacion utf-8 para preservar caracteres especiales en los titulos.
import pandas as pd

df = pd.DataFrame(todas_las_peliculas)
df.to_csv("peliculas_ciencia_ficcion.csv", index=False, encoding="utf-8")
El archivo resultante contiene una fila por pelicula con las columnas titulo, ano y calificacion. Se pueden anadir mas campos si se localizan en la pagina, como el numero de votos o la duracion.
Consideraciones de uso responsable
El scraping debe realizarse de forma respetuosa. Se recomienda consultar el archivo robots.txt del sitio y limitar la frecuencia de las peticiones. En 2026 muchos sitios implementan medidas anti-scraping; si las peticiones comienzan a fallar se puede aumentar el tiempo de espera o revisar si el sitio ofrece una API oficial. IMDb dispone de conjuntos de datos publicos que pueden ser una alternativa cuando se necesita informacion a gran escala.
Es importante no sobrecargar el servidor y utilizar los datos extraidos de acuerdo con los terminos de servicio del sitio. Para proyectos personales o de investigacion el scraping moderado suele ser aceptable, pero para usos comerciales se debe verificar la autorizacion correspondiente.
Manejo de errores y robustez
Un scraper robusto debe manejar excepciones de red, tiempos de espera y cambios en la estructura de la pagina. Se pueden envolver las peticiones en bloques try-except y registrar los errores. Si un selector deja de funcionar, el programa puede continuar con las paginas restantes y reportar las fallidas.
try:
    html = obtener_pagina(url, headers)
    peliculas = extraer_peliculas(html)
except requests.RequestException as e:
    print(f"Error al obtener {url}: {e}")
La inclusion de registros permite identificar que paginas fallaron y reintentarlas mas tarde. Tambien es util validar que cada pelicula extraida contenga al menos el titulo antes de agregarla a la lista de resultados.
Conclusiones
El web scraping con Python y BeautifulSoup permite extraer de forma sistematica los datos de peliculas de ciencia ficcion listadas en IMDb. El proceso incluye la inspeccion de la estructura HTML, la realizacion de peticiones con encabezados adecuados, el manejo de la paginacion, la limpieza de los datos y el almacenamiento en CSV. En 2026 estas tecnicas siguen siendo utiles para sitios que sirven contenido en HTML, siempre que se apliquen de manera responsable y se respeten los limites del servidor. Con el codigo descrito se obtiene un conjunto de datos limpio que puede utilizarse para analisis posteriores o para alimentar otras aplicaciones. La practica de inspeccionar selectores y manejar errores mejora la robustez del scraper y facilita su mantenimiento cuando la pagina de origen cambia.