Introduccion al protocolo HTTP en el desarrollo web actual
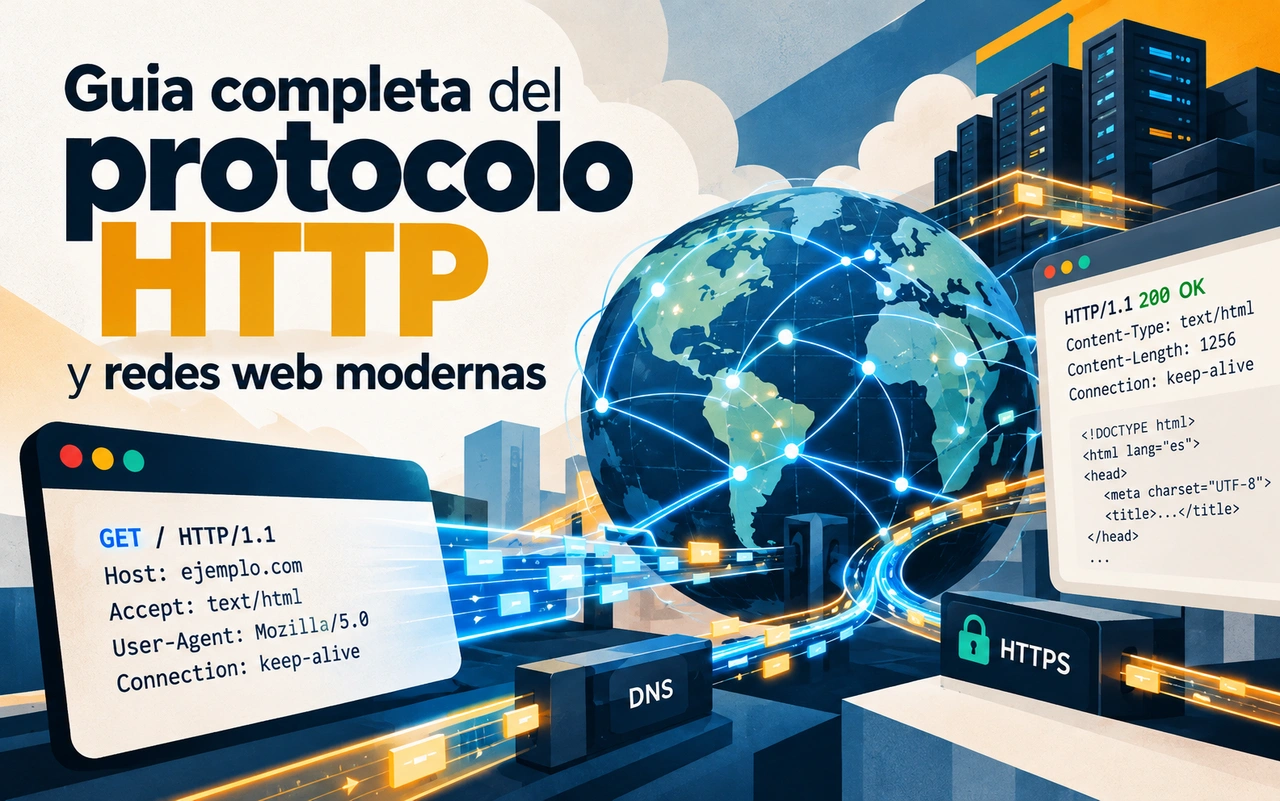
El protocolo HTTP constituye la base sobre la que se construye toda la comunicacion de datos en la World Wide Web. Cada vez que un navegador solicita una pagina, una aplicacion movil recupera informacion de un servidor o un servicio backend intercambia datos con otro sistema, el intercambio se realiza mediante este protocolo. En 2026 el panorama de redes web ha evolucionado significativamente: HTTP/2 sigue siendo el protocolo dominante en la mayoria del trafico, HTTP/3 con QUIC ha alcanzado una adopcion estable alrededor del 20 por ciento de las peticiones globales, y la seguridad mediante TLS 1.3 se ha consolidado como el estandar practico. Comprender el funcionamiento interno de HTTP resulta imprescindible para cualquier profesional que trabaje en desarrollo backend, frontend o infraestructura.
Este articulo ofrece una vision completa y actualizada de los conceptos fundamentales del protocolo. Se abordan desde la importancia de HTTP y el funcionamiento del sistema de nombres de dominio hasta el uso de cabeceras, metodos, JSON y la implementacion de seguridad con HTTPS. Todos los ejemplos se presentan en JavaScript utilizando la API Fetch nativa, de modo que puedan ejecutarse tanto en el navegador como en entornos Node.js modernos. El objetivo es proporcionar una base solida que permita al lector interpretar trafico de red, depurar problemas de comunicacion y disenar APIs robustas.
La comunicacion entre dispositivos a traves de internet requiere un conjunto de reglas compartidas. Sin un protocolo comun, dos computadoras no podrian intercambiar informacion de forma coherente. HTTP proporciona esas reglas de manera sencilla y extensible, lo que explica su permanencia durante mas de tres decadas y su continua evolucion hacia versiones mas eficientes.
Importancia de HTTP en las aplicaciones modernas
Las aplicaciones contemporaneas dependen de la capacidad de transferir datos entre dispositivos de forma fiable y estandarizada. Un servicio de correo electronico no almacena los mensajes unicamente en el dispositivo del usuario; los mantiene en servidores remotos a los que se accede mediante peticiones HTTP. De igual forma, las plataformas de mensajeria instantanea, las redes sociales y los sistemas de gestion de contenido utilizan este protocolo para sincronizar informacion entre multiples clientes.
HTTP opera bajo un modelo cliente-servidor. El cliente inicia la comunicacion enviando una peticion, y el servidor responde con los datos solicitados o con un mensaje de error. Esta separacion de roles permite que un mismo servidor atienda simultaneamente a miles de clientes, cada uno de los cuales puede ser un navegador, una aplicacion movil o incluso otro servicio backend.
Un aspecto clave del diseno de HTTP es su naturaleza sin estado. Cada peticion se trata de forma independiente; el servidor no conserva informacion sobre peticiones anteriores a menos que se implementen mecanismos adicionales como cookies o tokens de sesion. Esta caracteristica simplifica la escalabilidad, ya que cualquier instancia de un servicio puede procesar cualquier peticion sin necesidad de compartir estado en memoria.
En la practica, cuando un usuario visita un sitio web, el navegador realiza una serie de peticiones HTTP para obtener el documento HTML, las hojas de estilo, las imagenes y los scripts necesarios. El servidor responde a cada una de ellas con el recurso correspondiente y un codigo de estado que indica el resultado de la operacion. El codigo 200 significa que la peticion se completo correctamente, mientras que codigos de la familia 4xx y 5xx senalan errores del cliente o del servidor respectivamente.
El siguiente ejemplo ilustra una peticion basica utilizando la API Fetch:
async function obtenerListaPokemon() {
    const respuesta = await fetch("https://pokeapi.co/api/v2/pokemon/", {
        method: "GET",
        headers: {
            "Content-Type": "application/json",
        },
    });
    const datos = await respuesta.json();
    return datos.results;
}

obtenerListaPokemon().then((pokemons) => {
    pokemons.forEach((pokemon) => console.log(pokemon.name));
});
Este fragmento demuestra como un cliente solicita un recurso y procesa la respuesta. La llamada a fetch inicia la peticion HTTP, y el metodo json convierte el cuerpo de la respuesta en un objeto JavaScript utilizable.
Funcionamiento del sistema de nombres de dominio
Antes de que un cliente pueda establecer una conexion HTTP con un servidor, debe resolver el nombre de dominio a una direccion IP. El sistema de nombres de dominio, conocido como DNS, actua como la agenda telefonica de internet. Los usuarios recuerdan facilmente nombres como example.com, pero las computadoras necesitan direcciones numericas para localizar los destinos en la red.
Cuando se introduce una URL en el navegador, el sistema operativo consulta primero su cache local de resoluciones DNS. Si no encuentra la entrada, envia una consulta a un servidor DNS configurado, generalmente el proporcionado por el proveedor de internet o un servicio publico como los de Cloudflare o Google. Ese servidor puede responder directamente o reenviar la consulta a servidores raiz y de dominios de nivel superior hasta obtener la direccion IP correspondiente.
El proceso de resolucion involucra varios tipos de registros. El registro de tipo A asocia un nombre de dominio con una direccion IPv4, mientras que el registro AAAA hace lo propio con IPv6. Existen tambien registros CNAME que permiten alias y registros MX destinados al enrutamiento de correo electronico.
Un ejemplo practico de consulta DNS mediante la API publica de Cloudflare es el siguiente:
async function resolverDireccionIP(dominio) {
    const respuesta = await fetch(
        `https://cloudflare-dns.com/dns-query?name=${dominio}&type=A`,
        {
            headers: {
                Accept: "application/dns-json",
            },
        }
    );
    const datos = await respuesta.json();
    if (datos.Answer && datos.Answer.length > 0) {
        return datos.Answer[0].data;
    }
    return null;
}

const ip = await resolverDireccionIP("api.boot.dev");
console.log(`Direccion IP encontrada: ${ip}`);
Este codigo muestra como obtener la direccion IP asociada a un dominio sin depender de herramientas externas. En entornos de produccion, la resolucion DNS suele estar optimizada mediante caches y servidores anycast para reducir la latencia.
Los subdominios anaden flexibilidad al sistema. Un mismo dominio puede apuntar a multiples servidores mediante subdominios distintos. Por ejemplo, blog.example.com y api.example.com pueden residir en infraestructuras completamente separadas, cada una con su propia direccion IP. Esta capacidad resulta fundamental para arquitecturas de microservicios y para la separacion de entornos de desarrollo, pruebas y produccion.
Diferencias entre URI y URL
Un identificador uniforme de recursos, o URI, es una cadena de caracteres que identifica de forma unica un recurso. Las URL constituyen un subconjunto de los URI que ademas proporcionan la ubicacion del recurso y el mecanismo para acceder a el. En la practica cotidiana, la mayoria de las personas utilizan el termino URL de forma generica, pero es importante distinguir ambos conceptos.
Una URI puede ser un nombre (URN) o un localizador (URL). Un ejemplo de URN es el identificador de un libro en formato ISBN, que nombra el recurso sin indicar donde encontrarlo. Una URL, en cambio, incluye el protocolo, el host y la ruta necesarios para recuperarlo.
Las URL se componen de varias partes bien definidas. El protocolo o esquema indica el conjunto de reglas de comunicacion (http, https, ftp, mailto, etc.). El nombre de usuario y la contrasena son opcionales y rara vez se utilizan en contextos web modernos por razones de seguridad. El hostname identifica el servidor, el puerto especifica el punto de entrada de la conexion, la ruta senala el recurso concreto, los parametros de consulta permiten pasar informacion adicional y el fragmento identifica una seccion dentro del recurso.
El siguiente codigo utiliza la API URL de JavaScript para descomponer una direccion completa:
function mostrarPartesURL(cadenaURL) {
    const objetoURL = new URL(cadenaURL);
    console.log(`Protocolo: ${objetoURL.protocol}`);
    console.log(`Usuario: ${objetoURL.username}`);
    console.log(`Contrasena: ${objetoURL.password}`);
    console.log(`Hostname: ${objetoURL.hostname}`);
    console.log(`Puerto: ${objetoURL.port}`);
    console.log(`Ruta: ${objetoURL.pathname}`);
    console.log(`Consulta: ${objetoURL.search}`);
    console.log(`Fragmento: ${objetoURL.hash}`);
}

mostrarPartesURL(
    "http://usuario:[email protected]:8080/ruta?ordenar=asc#seccion"
);
La salida de este programa revela cada componente de la URL de forma estructurada. En la mayoria de las peticiones web cotidianas, el puerto se omite porque se utilizan los valores por defecto: 80 para HTTP y 443 para HTTPS.
Las rutas en las URL modernas no necesariamente reflejan la estructura de archivos del servidor. En las aplicaciones actuales, la ruta suele actuar como un parametro adicional que el servidor interpreta para determinar que recurso o accion debe ejecutarse. Los parametros de consulta, por su parte, permiten filtrar, ordenar o paginar resultados sin alterar la ruta base.
Programacion asincrona y manejo de errores en peticiones de red
Las operaciones de red introducen latencia inevitable. El tiempo que tarda un paquete en viajar desde el cliente hasta el servidor y regresar puede oscilar entre decenas y cientos de milisegundos. Si el codigo de la aplicacion esperara de forma sincrona a que cada peticion finalizara, la interfaz de usuario se congelaria y la experiencia se degradaria de forma notable.
JavaScript aborda este problema mediante el modelo de programacion asincrona basado en promesas y la sintaxis async/await. Una promesa representa un valor que estara disponible en el futuro. Puede resolverse con un resultado exitoso o rechazarse con un error. La palabra clave await suspende la ejecucion de la funcion asincrona hasta que la promesa se complete, sin bloquear el hilo principal.
El siguiente ejemplo ilustra el uso correcto de async/await junto con el manejo de errores:
async function obtenerDatosSeguros(url) {
    try {
        const respuesta = await fetch(url);
        if (!respuesta.ok) {
            throw new Error(`Error HTTP: ${respuesta.status}`);
        }
        const datos = await respuesta.json();
        return datos;
    } catch (error) {
        console.error("Fallo en la peticion:", error.message);
        return null;
    }
}

const resultado = await obtenerDatosSeguros(
    "https://pokeapi.co/api/v2/pokemon/1"
);
if (resultado) {
    console.log(resultado.name);
}
El bloque try/catch captura tanto errores de red como respuestas con codigos de estado inesperados. Comprobar la propiedad ok de la respuesta es una practica recomendada, ya que fetch solo rechaza la promesa ante fallos de red o CORS, no ante codigos HTTP de error.
En aplicaciones reales es frecuente necesitar reintentos automaticos ante fallos transitorios. Una implementacion sencilla puede envolver la peticion en un bucle con retardo exponencial:
async function fetchConReintentos(url, intentos = 3) {
    for (let i = 0; i < intentos; i++) {
        try {
            const respuesta = await fetch(url);
            if (respuesta.ok) return respuesta;
        } catch (error) {
            if (i === intentos - 1) throw error;
            await new Promise((r) => setTimeout(r, 1000 * Math.pow(2, i)));
        }
    }
}
Este patron mejora la resiliencia de las aplicaciones frente a congestiones temporales de red o reinicios de servicios.
Cabeceras HTTP y su papel en la comunicacion
Las cabeceras HTTP constituyen un mecanismo de extension del protocolo. Permiten al cliente y al servidor intercambiar informacion meta adicional sobre la peticion o la respuesta. Cada cabecera se expresa como un par nombre-valor y se envia en texto claro en las versiones 1.x del protocolo, o de forma comprimida en HTTP/2 y HTTP/3.
Algunas cabeceras son de uso general y aparecen tanto en peticiones como en respuestas. Content-Type indica el formato del cuerpo del mensaje, Content-Length especifica su tamano en bytes y Cache-Control define politicas de almacenamiento en cache. Otras cabeceras son especificas de la peticion, como Accept, que comunica los tipos de contenido que el cliente esta dispuesto a recibir, o Authorization, que transporta credenciales de autenticacion.
En el lado de la respuesta, cabeceras como Set-Cookie permiten al servidor establecer cookies en el cliente, mientras que Location se utiliza en redirecciones. La cabecera Strict-Transport-Security instruye al navegador para que utilice unicamente conexiones HTTPS en futuras visitas al dominio.
El siguiente ejemplo muestra como enviar y leer cabeceras personalizadas:
async function peticionConCabeceras() {
    const respuesta = await fetch("https://httpbin.org/headers", {
        method: "GET",
        headers: {
            "Content-Type": "application/json",
            "X-Custom-Header": "valor-personalizado",
            "Accept-Language": "es-ES",
        },
    });
    const datos = await respuesta.json();
    console.log(datos.headers);
    console.log(
        "Tipo de contenido de la respuesta:",
        respuesta.headers.get("content-type")
    );
}
Las cabeceras personalizadas que comienzan con X- se utilizan tradicionalmente para extensiones no estandar, aunque la tendencia actual es registrar nombres oficiales cuando es posible. En cualquier caso, el servidor debe estar preparado para interpretarlas correctamente.
El control de cache mediante cabeceras es especialmente relevante para el rendimiento. Una configuracion adecuada de Cache-Control y ETag puede reducir drasticamente la cantidad de datos transferidos en visitas posteriores a un mismo recurso. Los servidores modernos combinan estas cabeceras con estrategias de invalidacion para mantener la consistencia de los datos.
JSON como formato estandar de intercambio de datos
JavaScript Object Notation, conocido como JSON, se ha convertido en el formato de intercambio de datos predominante en las APIs web. Su sintaxis simple, basada en objetos y arrays, resulta facil de leer tanto para humanos como para maquinas. A diferencia de XML, JSON no requiere etiquetas de cierre ni esquemas complejos, lo que reduce el tamano de los mensajes y simplifica el procesamiento.
Un documento JSON valido debe cumplir reglas estrictas: las claves de los objetos deben ir entre comillas dobles, los valores pueden ser cadenas, numeros, booleanos, null, arrays u otros objetos, y no se permiten comentarios. La mayoria de los lenguajes de programacion incluyen bibliotecas nativas para convertir estructuras de datos locales a JSON y viceversa.
En JavaScript, los metodos JSON.stringify y JSON.parse realizan estas conversiones:
const objeto = {
    nombre: "Pikachu",
    tipo: "electrico",
    nivel: 25,
    movimientos: ["impactrueno", "ataque rapido"],
};

const textoJSON = JSON.stringify(objeto);
console.log(textoJSON);

const objetoRecuperado = JSON.parse(textoJSON);
console.log(objetoRecuperado.nombre);
Cuando se trabaja con la API Fetch, el metodo response.json() combina la lectura del cuerpo de la respuesta con el analisis JSON en una sola operacion. Es importante verificar que el servidor haya enviado realmente un cuerpo en formato JSON, lo cual se puede comprobar mediante la cabecera Content-Type.
En escenarios de alto rendimiento, el uso de JSON puede convertirse en un cuello de botella si los mensajes son muy grandes. Alternativas como Protocol Buffers o MessagePack ofrecen mayor densidad de informacion, aunque a costa de una menor legibilidad. Para la mayoria de las APIs publicas y privadas, JSON sigue siendo la opcion mas equilibrada.
Metodos HTTP y su semántica
El protocolo HTTP define varios metodos que indican la accion que el cliente desea realizar sobre el recurso identificado por la URL. Los metodos mas comunes son GET, POST, PUT, PATCH y DELETE, cada uno con una semantica bien definida que los servidores y los intermediarios deben respetar.
GET se utiliza para recuperar un recurso sin modificar el estado del servidor. Las peticiones GET deben ser seguras e idempotentes: ejecutarlas multiples veces produce el mismo resultado y no genera efectos secundarios. POST se emplea para crear nuevos recursos o para enviar datos que provocan cambios de estado. A diferencia de GET, POST no es idempotente; cada peticion puede generar un nuevo recurso.
PUT se utiliza para reemplazar completamente un recurso existente o crearlo si no existe. PATCH permite aplicar modificaciones parciales. DELETE solicita la eliminacion del recurso. Tanto PUT como DELETE son idempotentes.
El siguiente ejemplo muestra el uso de distintos metodos:
async function crearRecurso(datos) {
    const respuesta = await fetch("https://httpbin.org/post", {
        method: "POST",
        headers: {
            "Content-Type": "application/json",
        },
        body: JSON.stringify(datos),
    });
    return respuesta.json();
}

async function actualizarRecurso(id, datos) {
    const respuesta = await fetch(`https://httpbin.org/put/${id}`, {
        method: "PUT",
        headers: {
            "Content-Type": "application/json",
        },
        body: JSON.stringify(datos),
    });
    return respuesta.json();
}

async function eliminarRecurso(id) {
    const respuesta = await fetch(`https://httpbin.org/delete/${id}`, {
        method: "DELETE",
    });
    return respuesta.status;
}
Respetar la semantica de los metodos facilita la implementacion de caches, proxies y herramientas de monitoreo. Un proxy puede cachear respuestas GET de forma segura, pero no debe hacerlo con respuestas POST. De igual manera, los clientes pueden reintentar de forma automatica peticiones GET o PUT ante fallos de red, pero deben ser mas cautelosos con POST.
Rutas de URL y parametros de consulta
La ruta de una URL identifica el recurso concreto que el cliente desea manipular. En las aplicaciones REST, las rutas suelen seguir convenciones que reflejan la jerarquia de los recursos. Por ejemplo, /usuarios/42/pedidos representa la coleccion de pedidos del usuario con identificador 42.
Los parametros de consulta se anaden despues del signo de interrogacion y permiten filtrar, ordenar o paginar resultados sin alterar la estructura de la ruta. Un ejemplo tipico es /productos?categoria=electronica&ordenar=precio&pagina=2. El servidor interpreta estos parametros y ajusta la respuesta en consecuencia.
La API URL de JavaScript facilita la construccion y el analisis de estos componentes:
const urlBase = new URL("https://api.ejemplo.com/productos");
urlBase.searchParams.append("categoria", "electronica");
urlBase.searchParams.append("ordenar", "precio");
urlBase.searchParams.set("pagina", "2");

console.log(urlBase.toString());
// https://api.ejemplo.com/productos?categoria=electronica&ordenar=precio&pagina=2
El objeto searchParams ofrece metodos para anadir, eliminar y consultar parametros de forma segura, evitando problemas de codificacion de caracteres especiales.
En aplicaciones modernas es frecuente utilizar rutas dinamicas que el servidor interpreta mediante un enrutador. Frameworks como Express en Node.js o similares en otros lenguajes permiten definir patrones de ruta con parametros variables, lo que simplifica la extraccion de identificadores y la organizacion del codigo.
Seguridad mediante HTTPS y TLS
HTTP transmite los datos en texto claro, lo que permite a cualquier intermediario en la ruta de red inspeccionar o modificar el contenido de las peticiones y respuestas. HTTPS soluciona este problema al encapsular el trafico HTTP dentro de una conexion cifrada mediante TLS (Transport Layer Security).
TLS garantiza tres propiedades fundamentales: confidencialidad, integridad y autenticacion. La confidencialidad se logra mediante cifrado simetrico de los datos. La integridad se verifica con codigos de autenticacion de mensajes. La autenticacion se basa en certificados digitales emitidos por autoridades de confianza que confirman la identidad del servidor.
En 2026, TLS 1.3 es la version predominante y ofrece mejoras significativas respecto a versiones anteriores: handshake de un solo round-trip, eliminacion de algoritmos criptograficos debiles y mayor resistencia a ataques de degradacion. HTTP/3 integra TLS de forma nativa dentro del protocolo QUIC, eliminando la necesidad de una capa adicional.
Para forzar el uso de HTTPS, los servidores suelen enviar la cabecera Strict-Transport-Security (HSTS). Esta cabecera indica al navegador que en futuras visitas debe conectarse unicamente mediante HTTPS, incluso si el usuario introduce una URL con el esquema http.
Un ejemplo de configuracion basica de una peticion segura es simplemente utilizar el esquema https en la URL:
const respuesta = await fetch("https://api.ejemplo.com/datos-sensibles", {
    method: "GET",
    headers: {
        Authorization: "Bearer token-seguro",
    },
});
El navegador y las bibliotecas de red se encargan automaticamente de negociar la conexion TLS, verificar el certificado del servidor y cifrar el trafico. En entornos de desarrollo es posible encontrar certificados autofirmados; en produccion siempre deben utilizarse certificados emitidos por autoridades reconocidas o mediante servicios de emision automatica como Let’s Encrypt.
La migracion completa a HTTPS es hoy una practica estandar. Los navegadores modernos marcan como no seguras las paginas que continuan utilizando HTTP puro, y muchos servicios de analitica y publicidad dejan de funcionar en contextos mixtos. Ademas, protocolos como HTTP/2 y HTTP/3 requieren de forma obligatoria el uso de TLS.
Construccion de un rastreador web basico
Para consolidar los conceptos presentados, resulta util construir un pequeno rastreador web que visite paginas, extraiga enlaces y genere un informe sencillo. El proceso comienza con la normalizacion de URLs, continua con la extraccion de hipervinculos del HTML y finaliza con el recorrido recursivo de un conjunto de paginas.
La normalizacion de URLs garantiza que distintas representaciones del mismo recurso se traten de forma identica. Esto incluye convertir el esquema y el hostname a minusculas, eliminar el puerto por defecto y resolver rutas relativas.
function normalizarURL(urlString, baseURL) {
    const url = new URL(urlString, baseURL);
    url.hash = "";
    if (
        (url.protocol === "http:" && url.port === "80") ||
        (url.protocol === "https:" && url.port === "443")
    ) {
        url.port = "";
    }
    return url.href;
}
La extraccion de enlaces puede realizarse mediante expresiones regulares o, de forma mas robusta, con un analizador HTML. En entornos Node.js se suele utilizar la biblioteca jsdom o cheerio. El siguiente ejemplo simplificado utiliza una expresion regular para ilustrar el concepto:
function extraerURLs(html, baseURL) {
    const regex = /href=["']([^"']+)["']/gi;
    const urls = new Set();
    let coincidencia;
    while ((coincidencia = regex.exec(html)) !== null) {
        try {
            const normalizada = normalizarURL(coincidencia[1], baseURL);
            urls.add(normalizada);
        } catch (e) {
            // Ignorar URLs invalidas
        }
    }
    return Array.from(urls);
}
El recorrido recursivo debe controlar la profundidad maxima y evitar ciclos mediante un conjunto de URLs ya visitadas. Cada pagina visitada incrementa un contador que al final permite generar un informe basico de SEO.
async function rastrear(urlInicial, profundidadMaxima = 2) {
    const visitadas = new Set();
    const cola = [{ url: urlInicial, profundidad: 0 }];
    const informe = {};

    while (cola.length > 0) {
        const { url, profundidad } = cola.shift();
        if (visitadas.has(url) || profundidad > profundidadMaxima) continue;
        visitadas.add(url);

        try {
            const respuesta = await fetch(url);
            const html = await respuesta.text();
            informe[url] = { estado: respuesta.status, longitud: html.length };

            if (profundidad < profundidadMaxima) {
                const enlaces = extraerURLs(html, url);
                for (const enlace of enlaces) {
                    if (!visitadas.has(enlace)) {
                        cola.push({
                            url: enlace,
                            profundidad: profundidad + 1,
                        });
                    }
                }
            }
        } catch (error) {
            informe[url] = { estado: "error", mensaje: error.message };
        }
    }

    return informe;
}
Este rastreador ilustra de forma practica la mayoria de los conceptos tratados: resolucion de URLs, peticiones HTTP, manejo de respuestas, extraccion de datos y control de flujo asincrono. En un entorno de produccion se anadirian limites de tasa, respeto a robots.txt y almacenamiento persistente de los resultados.
Conclusiones
El protocolo HTTP sigue siendo el pilar fundamental de la comunicacion en la web. Su diseno simple y extensible ha permitido que evolucione desde las primeras transferencias de documentos hipertexto hasta el soporte de aplicaciones complejas, streaming de video y APIs de alto rendimiento. Comprender el papel del DNS, la estructura de las URL, el uso correcto de cabeceras y metodos, el formato JSON y las garantias de seguridad que aporta HTTPS proporciona una base solida para cualquier desarrollador.
En el contexto actual de 2026, la adopcion de HTTP/3 y TLS 1.3 introduce mejoras de latencia y resiliencia, especialmente en redes moviles y entornos con perdida de paquetes. Sin embargo, los conceptos fundamentales descritos en este articulo permanecen validos y son independientes de la version concreta del protocolo. Dominar estos fundamentos permite diagnosticar problemas de red, disenar APIs coherentes y construir sistemas distribuidos mas robustos.
La practica continua con herramientas de inspeccion de trafico, la lectura de especificaciones oficiales y la experimentacion con implementaciones reales consolidan el conocimiento teorico. HTTP no es solo un protocolo de transporte; es el lenguaje comun que hace posible la interconexion de sistemas a escala global.