Introduccion al aprendizaje profundo con PyTorch
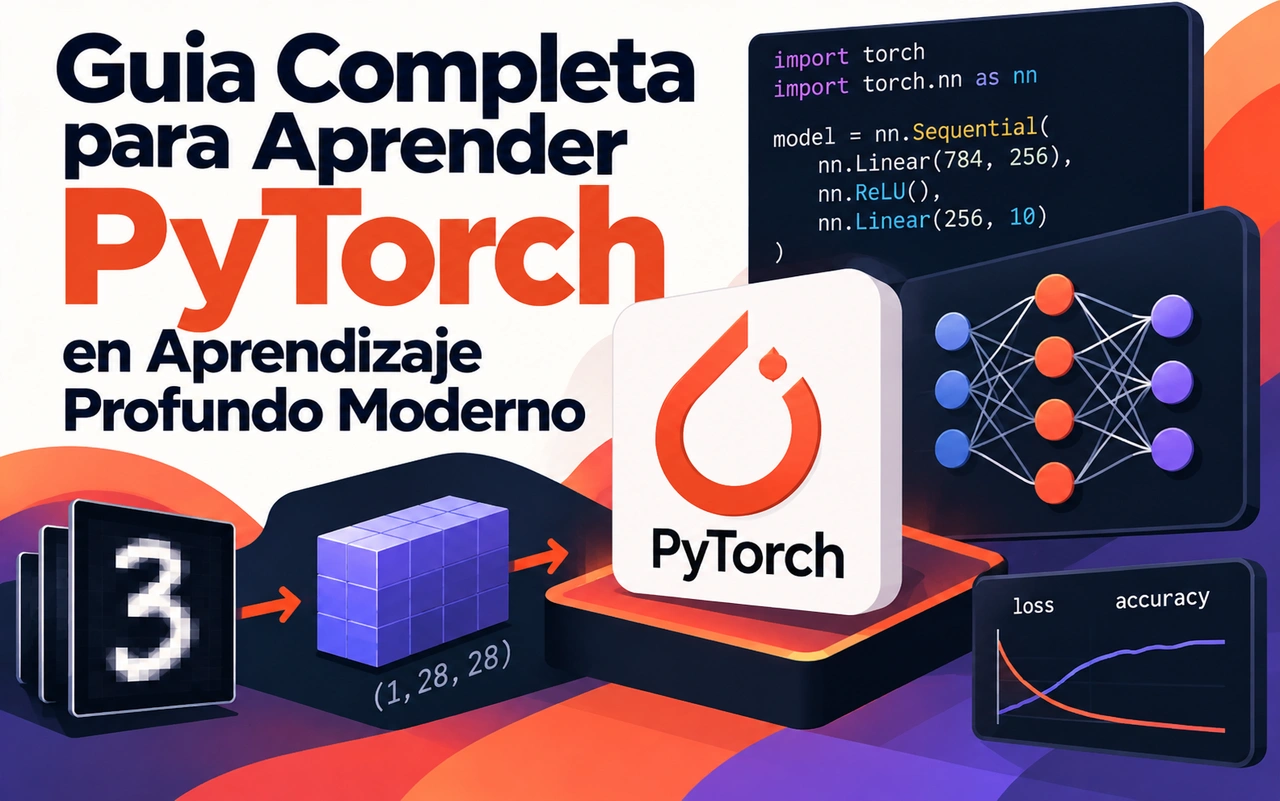
PyTorch se ha consolidado como el marco de trabajo preferido para investigacion y produccion en aprendizaje profundo. Su interfaz pitonica, su grafo de computacion dinamico y su ecosistema maduro permiten pasar de ideas a modelos entrenados con relativa facilidad. En 2026 PyTorch 2.x incorpora herramientas como torch.compile que aceleran tanto el entrenamiento como la inferencia sin cambios sustanciales en el codigo.
Esta guia recorre los conceptos esenciales para comenzar a construir modelos de aprendizaje profundo. Partimos de los tensores, el bloque fundamental, y avanzamos hasta la construccion de redes neuronales, el ciclo de entrenamiento, la evaluacion y las practicas recomendadas para entornos reales. El enfoque es practico: cada seccion incluye ejemplos de codigo que se pueden ejecutar de forma inmediata.
El dominio de PyTorch abre la puerta a tareas de clasificacion de imagenes, procesamiento de lenguaje natural, modelos generativos y sistemas de recomendacion. Aunque existen marcos de alto nivel que abstraen parte de la complejidad, comprender el funcionamiento interno de PyTorch resulta indispensable para depurar, personalizar arquitecturas y optimizar rendimiento.
Fundamentos de tensores y operaciones basicas
Un tensor es la estructura de datos central de PyTorch. Representa arreglos multidimensionales que pueden residir en CPU o GPU y que mantienen un registro de las operaciones realizadas sobre ellos cuando se activa el calculo de gradientes. Crear un tensor escalar, un vector o una matriz es sencillo:
import torch

escalar = torch.tensor(7)
vector = torch.tensor([1.0, 2.0, 3.0])
matriz = torch.tensor([[1, 2], [3, 4]])
print(matriz.shape)
print(matriz.dtype)
Los atributos mas utiles son shape, dtype y device. La forma indica las dimensiones, el tipo de dato determina la precision numerica y el dispositivo indica si el tensor vive en CPU o en un acelerador. Para mover un tensor a GPU se utiliza:
if torch.cuda.is_available():
    matriz = matriz.to("cuda")
Las operaciones aritmeticas, de reduccion y de cambio de forma se realizan de manera vectorizada. La multiplicacion matricial, esencial en redes neuronales, se ejecuta con el operador @ o con torch.matmul:
a = torch.rand(2, 3)
b = torch.rand(3, 4)
resultado = a @ b
print(resultado.shape)
Es fundamental vigilar la compatibilidad de formas. Un error comun consiste en intentar multiplicar matrices cuyas dimensiones internas no coinciden. PyTorch reporta el problema de forma clara, pero la practica de imprimir las formas intermedias acelera la depuracion.
Autograd y calculo automatico de gradientes
El motor de diferenciacion automatica de PyTorch, conocido como autograd, registra las operaciones realizadas sobre tensores que tienen requires_grad=True. Cuando se llama a backward sobre un escalar, se calcula el gradiente de ese escalar con respecto a todos los tensores hoja que participaron en el calculo.
Un ejemplo minimo ilustra el proceso:
x = torch.tensor(2.0, requires_grad=True)
y = x ** 2 + 3 * x
y.backward()
print(x.grad)
El gradiente almacenado en x.grad es 7, que coincide con la derivada analitica de y respecto a x evaluada en 2. En redes neuronales este mecanismo se aplica de forma automatica a millones de parametros. Los parametros de un modelo se declaran como nn.Parameter o se crean dentro de capas de torch.nn, por lo que autograd los rastrea sin intervencion adicional.
Para ahorrar memoria durante la inferencia se desactiva el calculo de gradientes con torch.no_grad o con model.eval combinado con el contexto adecuado. Esta practica es obligatoria en produccion porque reduce el consumo de memoria y acelera la evaluacion.
Construccion de modelos con torch.nn
Todos los modelos de PyTorch heredan de nn.Module. En el metodo init se definen las capas y en el metodo forward se especifica como los datos fluyen a traves de ellas. Un modelo lineal simple para regresion se escribe asi:
class ModeloLineal(nn.Module):
    def __init__(self):
        super().__init__()
        self.capa = nn.Linear(1, 1)

    def forward(self, x):
        return self.capa(x)
Para problemas de clasificacion se anaden capas ocultas y funciones de activacion. Una red neuronal de avance basica puede definirse con nn.Sequential o de forma explicita:
modelo = nn.Sequential(
    nn.Linear(2, 8),
    nn.ReLU(),
    nn.Linear(8, 1),
    nn.Sigmoid()
)
La eleccion entre Sequential y una clase personalizada depende de la complejidad. Sequential es conciso para arquitecturas lineales; una clase personalizada ofrece mayor flexibilidad cuando se requieren conexiones residuales, atencion o multiples entradas.
En 2026 se recomienda inicializar los pesos de forma explicita cuando se experimenta con arquitecturas nuevas. Funciones como nn.init.kaimingnormal o nn.init.xavieruniform mejoran la convergencia en redes profundas.
Ciclo de entrenamiento y optimizacion
El ciclo de entrenamiento sigue un patron bien establecido. Se coloca el modelo en modo entrenamiento, se recorren los lotes de datos, se calcula la perdida, se retropropaga el gradiente, se actualizan los parametros y se reinician los gradientes. Un bucle tipico es:
criterio = nn.CrossEntropyLoss()
optimizador = torch.optim.AdamW(modelo.parameters(), lr=1e-3, weight_decay=1e-4)

for epoca in range(num_epocas):
    modelo.train()
    for X, y in cargador_entrenamiento:
        X, y = X.to(dispositivo), y.to(dispositivo)
        optimizador.zero_grad()
        salida = modelo(X)
        perdida = criterio(salida, y)
        perdida.backward()
        torch.nn.utils.clip_grad_norm_(modelo.parameters(), max_norm=1.0)
        optimizador.step()
El recorte de gradientes evita explosiones numericas. AdamW se ha convertido en el optimizador por defecto para la mayoria de tareas porque desacopla la regularizacion de pesos del paso de actualizacion. Un programador de tasa de aprendizaje, como CosineAnnealingLR, mejora la convergencia en entrenamientos largos.
Durante la evaluacion se desactiva el calculo de gradientes y se coloca el modelo en modo evaluacion para que las capas de dropout y batch normalization se comporten correctamente:
modelo.eval()
with torch.no_grad():
    for X, y in cargador_validacion:
        X, y = X.to(dispositivo), y.to(dispositivo)
        salida = modelo(X)
        # calcular metricas
Vision por computadora y conjuntos de datos
Para tareas de imagenes se utiliza torchvision. Un DataLoader envuelve un Dataset y proporciona lotes de forma eficiente. El ejemplo clasico de FashionMNIST ilustra el flujo completo:
from torchvision import datasets, transforms
from torch.utils.data import DataLoader

transformacion = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])
conjunto = datasets.FashionMNIST(root="datos", train=True, download=True, transform=transformacion)
cargador = DataLoader(conjunto, batch_size=64, shuffle=True, num_workers=4, pin_memory=True)
Los parametros num_workers y pin_memory mejoran el rendimiento cuando se entrena en GPU. Una red convolucional basica se construye con capas Conv2d, MaxPool2d y Linear. En la practica se recurre a arquitecturas preentrenadas mediante el argumento weights de torchvision.models, que reemplaza al antiguo parametro pretrained.
La aumentacion de datos, mediante transforms.RandomHorizontalFlip o bibliotecas como albumentations, reduce el sobreajuste. En 2026 las tecnicas de precision mixta mediante torch.amp aceleran el entrenamiento en GPUs modernas sin perdida apreciable de precision.
Mejores practicas y optimizacion en 2026
Varias practicas distinguen un script de investigacion de uno de produccion. En primer lugar, se utiliza codigo agnostico al dispositivo:
dispositivo = "cuda" if torch.cuda.is_available() else "cpu"
modelo = modelo.to(dispositivo)
En segundo lugar, se habilita torch.compile cuando el modelo es compatible. Esta transformacion aplica optimizaciones de grafo y puede reducir el tiempo de entrenamiento de forma notable:
modelo_compilado = torch.compile(modelo)
La precision mixta automatica se activa con un GradScaler o con el contexto torch.amp.autocast. En GPUs con Tensor Cores el beneficio es sustancial. Se recomienda guardar el mejor modelo segun la metrica de validacion y no segun la ultima epoca, utilizando torch.save con el state_dict.
El seguimiento de experimentos con herramientas ligeras o con TensorBoard ayuda a comparar configuraciones. Finalmente, se separa el codigo en modulos (datos, modelo, entrenamiento, evaluacion) para facilitar el mantenimiento y las pruebas.
Errores comunes y como evitarlos
Un error frecuente es olvidar zero_grad antes de backward, lo que acumula gradientes de lotes anteriores y produce actualizaciones incorrectas. Otro problema aparece cuando se mezclan tensores de distintos dispositivos; PyTorch lanza una excepcion clara, pero el habito de mover tanto datos como modelo al mismo dispositivo lo previene.
La falta de normalizacion de entradas o el uso de tasas de aprendizaje demasiado altas provoca divergencia. Empezar con valores pequenos y escalar gradualmente, o utilizar un programador de calentamiento, mitiga el riesgo. En redes profundas la inicializacion inadecuada de pesos o la ausencia de normalizacion por lotes puede generar gradientes que desaparecen o explotan.
Por ultimo, no desactivar el calculo de gradientes durante la inferencia desperdicia memoria y tiempo. El contexto torch.no_grad o torch.inference_mode debe envolver toda evaluacion que no requiera retropropagacion.
Conclusiones
Aprender PyTorch proporciona las herramientas necesarias para construir, entrenar y desplegar modelos de aprendizaje profundo con control total sobre cada etapa. El dominio de tensores, autograd, la construccion de modulos y el ciclo de entrenamiento constituye la base sobre la que se construyen arquitecturas mas complejas. En 2026 las optimizaciones como torch.compile, la precision mixta y las practicas de codigo agnostico al dispositivo permiten obtener rendimiento de produccion sin sacrificar la legibilidad. La experimentacion continua con conjuntos de datos reales, la validacion rigurosa y la modularizacion del codigo convierten el conocimiento teorico en sistemas fiables. Con estos fundamentos es posible abordar desde clasificadores simples hasta modelos de vision o de lenguaje de mayor escala.