Dos términos que se usan como sinónimos y no lo son
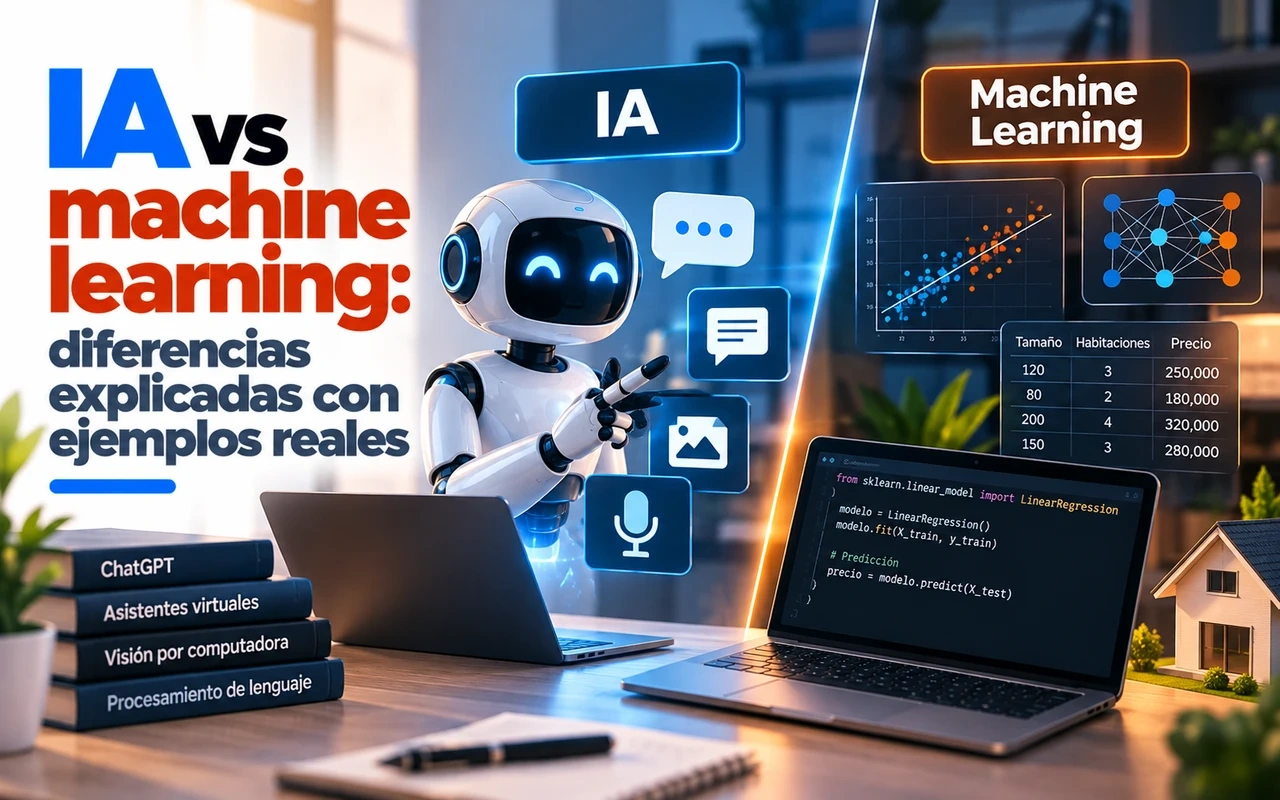
Inteligencia artificial y machine learning aparecen juntos en titulares, ofertas de empleo, presentaciones comerciales y conversaciones cotidianas, a menudo como si fueran exactamente lo mismo. Una aplicación de recomendaciones “usa IA”, un filtro antispam “usa machine learning” y un chatbot “usa ambas cosas”. La confusión es comprensible, porque los dos conceptos están estrechamente relacionados, pero mezclarlos dificulta entender qué hace realmente una tecnología, qué limitaciones tiene y qué se necesita para construirla.
La relación entre ambos es de inclusión: el machine learning es una de las formas de conseguir inteligencia artificial, probablemente la más importante hoy, pero no la única. Del mismo modo, dentro del machine learning existen subcampos como el deep learning, y dentro de este, tecnologías como los modelos de lenguaje que impulsan los asistentes conversacionales actuales.
En este artículo vamos a aclarar la diferencia entre IA y ML con definiciones precisas, ejemplos del mundo real y fragmentos de código en Python que muestran cada enfoque en acción. Veremos qué es la inteligencia artificial, qué es el aprendizaje automático y cómo funciona, cuáles son sus tipos, dónde encajan el deep learning y la IA generativa, y qué errores conceptuales conviene evitar. Al final tendrás un mapa claro para interpretar cualquier noticia o proyecto que mencione estas tecnologías.
Qué es la inteligencia artificial
La inteligencia artificial es el campo de la informática que busca crear sistemas capaces de realizar tareas que, cuando las hace una persona, consideramos que requieren inteligencia. Entre esas tareas están razonar, resolver problemas, planificar, comprender el lenguaje, reconocer imágenes, aprender de la experiencia y tomar decisiones en situaciones nuevas.
El término se acuñó a mediados de los años cincuenta, cuando un grupo de investigadores, entre ellos John McCarthy, propuso estudiar cómo hacer que las máquinas simularan aspectos de la inteligencia humana. Desde entonces, el campo ha atravesado periodos de entusiasmo y de desencanto, los llamados inviernos de la IA, hasta llegar a la explosión actual.
Lo importante es que la IA se define por su objetivo, no por su método. Cualquier técnica que permita a una máquina comportarse de forma inteligente entra en la definición. Históricamente, muchas de esas técnicas no tenían nada que ver con aprender de datos.
Un buen ejemplo son los sistemas basados en reglas, también llamados sistemas expertos. En ellos, una persona codifica explícitamente el conocimiento en forma de condiciones. Este pequeño programa clasifica correos como sospechosos usando reglas escritas a mano:
PALABRAS_SOSPECHOSAS = {"gratis", "premio", "ganado", "urgente", "contraseña"}

def es_sospechoso(asunto: str, remitente_conocido: bool) -> bool:
    palabras = set(asunto.lower().split())
    coincidencias = palabras & PALABRAS_SOSPECHOSAS
    if remitente_conocido:
        return len(coincidencias) >= 3
    return len(coincidencias) >= 1

print(es_sospechoso("Has ganado un premio gratis", remitente_conocido=False))
print(es_sospechoso("Informe de la reunión", remitente_conocido=True))
True
False
Este programa muestra un comportamiento que podríamos llamar inteligente: toma una decisión a partir de información incompleta. Pero no aprende nada. Si los remitentes de spam cambian sus palabras, alguien tendrá que actualizar las reglas a mano. Eso es inteligencia artificial clásica, también llamada simbólica, y sigue utilizándose hoy en motores de reglas de negocio, sistemas de diagnóstico, planificadores y videojuegos.
Otros ejemplos de IA que no dependen necesariamente del aprendizaje son los algoritmos de búsqueda que juegan al ajedrez explorando millones de jugadas posibles, los planificadores de rutas que encuentran el camino más corto en un mapa o los sistemas de satisfacción de restricciones que generan horarios.
Qué es el machine learning
El machine learning, o aprendizaje automático, es una rama de la inteligencia artificial en la que los sistemas aprenden patrones a partir de datos, en lugar de seguir reglas escritas explícitamente por una persona. Arthur Samuel, uno de los pioneros del campo, lo describió como la disciplina que da a los ordenadores la capacidad de aprender sin ser programados de forma explícita.
La diferencia con el enfoque anterior es fundamental. En la programación tradicional, una persona escribe las reglas, el programa recibe datos y produce resultados. En el machine learning, el sistema recibe datos y ejemplos de resultados esperados, y deduce por sí mismo las reglas que los relacionan. Esas reglas aprendidas forman lo que llamamos un modelo.
Veamos el mismo problema del correo resuelto con machine learning en Python y scikit-learn, cuya versión estable actual pertenece a la serie 1.9. En lugar de escribir reglas, damos ejemplos etiquetados y dejamos que el modelo aprenda:
pip install scikit-learn
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.naive_bayes import MultinomialNB
from sklearn.pipeline import make_pipeline

correos = [
    "Gana un iPhone gratis haciendo clic aquí",
    "Oferta exclusiva: premio de 1000 euros",
    "Tu cuenta será bloqueada, verifica tu contraseña ya",
    "Has ganado un premio, reclama tu regalo gratis",
    "Reunión del equipo mañana a las 10",
    "Adjunto el informe trimestral de ventas",
    "¿Comemos juntos el viernes?",
    "Recordatorio: revisión del código a las 16h",
]
etiquetas = ["spam", "spam", "spam", "spam", "ok", "ok", "ok", "ok"]

modelo = make_pipeline(TfidfVectorizer(), MultinomialNB())
modelo.fit(correos, etiquetas)

nuevos = ["Reclama tu premio gratis hoy", "Te envío el informe de la reunión"]
for texto, prediccion in zip(nuevos, modelo.predict(nuevos)):
    print(f"{prediccion:>4} | {texto}")
spam | Reclama tu premio gratis hoy
  ok | Te envío el informe de la reunión
Nadie le ha dicho al modelo qué palabras son sospechosas. Las ha inferido a partir de los ejemplos. Si mañana cambian los patrones del spam, basta con reentrenarlo con datos nuevos. Con ocho ejemplos el modelo es, por supuesto, muy limitado; los filtros reales de los grandes servicios de correo aprenden de miles de millones de mensajes y de las señales de los propios usuarios cuando marcan algo como spam.
La regla práctica que resume la relación entre ambos conceptos es sencilla: todo machine learning es inteligencia artificial, pero no toda inteligencia artificial es machine learning.
Cómo aprende un modelo: datos, entrenamiento y evaluación
Detrás de cualquier sistema de machine learning hay un proceso bastante estándar. Entenderlo ayuda a desmitificar la tecnología y a valorar qué se necesita realmente para aplicarla.
El primer paso es reunir y preparar los datos. Cada ejemplo se describe mediante características, por ejemplo los metros cuadrados y el número de habitaciones de una vivienda, y, en muchos casos, una etiqueta con el resultado que queremos predecir, como su precio. La calidad de los datos determina en gran medida la calidad del modelo.
El segundo paso es dividir los datos. Una parte se usa para entrenar el modelo y otra se reserva para evaluarlo. Evaluar con datos que el modelo ya ha visto daría una idea engañosamente optimista de su rendimiento.
El tercer paso es el entrenamiento, en el que un algoritmo ajusta los parámetros internos del modelo para que sus predicciones se parezcan lo más posible a las etiquetas reales.
El cuarto paso es la evaluación con métricas adecuadas al problema. El ciclo de entrenamiento y evaluación de modelos se repite probando distintos algoritmos, ajustes y características hasta obtener un resultado satisfactorio:
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42, stratify=y
)

bosque = RandomForestClassifier(n_estimators=200, random_state=42)
bosque.fit(X_train, y_train)

predicciones = bosque.predict(X_test)
print(f"Precisión: {accuracy_score(y_test, predicciones):.2%}")
Precisión: 89.47%
Este ejemplo usa un bosque aleatorio, un algoritmo que combina muchos árboles de decisión, para clasificar flores en tres especies a partir de las medidas de sus pétalos y sépalos. Los árboles de decisión y los bosques aleatorios son algunos de los algoritmos más populares del aprendizaje supervisado por su buen rendimiento y su relativa interpretabilidad.
Una organización típica de un proyecto de machine learning refleja estas fases:
prediccion-precios/
├── data/
│   ├── raw/
│   └── processed/
├── notebooks/
│   └── exploracion.ipynb
├── src/
│   ├── preparar_datos.py
│   ├── entrenar.py
│   └── evaluar.py
├── models/
│   └── modelo_v1.joblib
└── requirements.txt
Tipos de aprendizaje automático
No todos los problemas se abordan igual. Los tipos de aprendizaje automático se distinguen sobre todo por la clase de datos y de retroalimentación disponibles durante el entrenamiento.
El aprendizaje supervisado utiliza ejemplos etiquetados: cada entrada viene acompañada de la respuesta correcta. Se divide en clasificación, cuando la respuesta es una categoría, como spam o no spam, y regresión, cuando es un número, como un precio:
import numpy as np
from sklearn.linear_model import LinearRegression

metros = np.array([[50], [70], [90], [110], [130]])
precio_miles = np.array([150, 205, 262, 318, 370])

regresion = LinearRegression().fit(metros, precio_miles)
print(f"{regresion.predict([[100]])[0]:.1f}")
288.6
El aprendizaje no supervisado trabaja con datos sin etiquetas y busca estructuras ocultas en ellos. El caso más conocido es el agrupamiento, o clustering, que reúne elementos similares. Una tienda puede usarlo para segmentar a sus clientes según su gasto y su frecuencia de compra sin definir de antemano los grupos:
import numpy as np
from sklearn.cluster import KMeans

# [gasto anual en euros, número de compras]
clientes = np.array([
    [120, 2], [150, 3], [130, 2],
    [900, 25], [950, 30], [880, 22],
    [400, 10], [420, 12],
])

kmeans = KMeans(n_clusters=3, n_init="auto", random_state=0).fit(clientes)
print(kmeans.labels_)
[1 1 1 0 0 0 2 2]
El algoritmo ha descubierto tres segmentos: clientes ocasionales, clientes intermedios y clientes muy activos, sin que nadie le dijera cuáles eran.
El aprendizaje por refuerzo funciona de otra manera. Un agente interactúa con un entorno, toma acciones y recibe recompensas o penalizaciones, y aprende con el tiempo qué estrategia maximiza la recompensa total. Es la técnica detrás de los sistemas que dominan juegos como el Go, de muchos avances en robótica y de parte del ajuste fino que se aplica a los modelos de lenguaje para que sus respuestas sean más útiles.
Entre ambos extremos existe además el aprendizaje autosupervisado, en el que el propio dato proporciona la etiqueta. Predecir la siguiente palabra de un texto es el ejemplo clásico, y es precisamente la forma en que se entrenan los grandes modelos de lenguaje.
Deep learning: el subconjunto que lo cambió todo
El deep learning, o aprendizaje profundo, es una rama del machine learning basada en redes neuronales artificiales con muchas capas. Cada capa transforma los datos y extrae representaciones cada vez más abstractas: en una imagen, las primeras capas detectan bordes, las siguientes formas y las últimas objetos completos.
Su gran ventaja frente al machine learning clásico es que aprende automáticamente las características relevantes a partir de datos en bruto, como píxeles, audio o texto. En los modelos clásicos, buena parte del trabajo consiste en diseñar a mano esas características; en el deep learning, la red las descubre por sí misma.
A cambio, necesita grandes volúmenes de datos y mucha capacidad de cómputo, normalmente mediante GPU o aceleradores especializados. La combinación de grandes conjuntos de datos, hardware más potente y mejores técnicas de entrenamiento explica el salto que ha dado la IA en la última década.
Un ejemplo mínimo con una red neuronal sencilla de scikit-learn ilustra la idea, aunque en proyectos reales de deep learning se usan frameworks especializados como PyTorch, JAX o TensorFlow:
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier

X, y = load_digits(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=0)

red = MLPClassifier(hidden_layer_sizes=(64, 32), max_iter=500, random_state=0)
red.fit(X_train / 16.0, y_train)

print(f"Precisión reconociendo dígitos: {red.score(X_test / 16.0, y_test):.2%}")
El modelo aprende a reconocer dígitos escritos a mano a partir de imágenes de 8 por 8 píxeles, sin que nadie le explique cómo es un tres o un siete.
La relación entre todos estos conceptos puede representarse como círculos concéntricos:
Inteligencia artificial
├── IA simbólica (reglas, búsqueda, planificación)
└── Machine learning
    ├── Modelos clásicos (árboles, regresión, SVM, k-means)
    └── Deep learning
        ├── Visión por computador (redes convolucionales)
        └── Transformers
            └── Modelos de lenguaje e IA generativa
IA generativa y modelos de lenguaje
La gran novedad de los últimos años es la inteligencia artificial generativa: sistemas capaces de crear contenido nuevo, como texto, imágenes, audio, vídeo o código, en lugar de limitarse a clasificar o predecir valores. Los asistentes conversacionales que hoy usan millones de personas, los generadores de imágenes y las herramientas de programación asistida pertenecen a esta categoría.
Los modelos de lenguaje grandes son la tecnología central de la IA generativa de texto. Se basan en la arquitectura transformer, un tipo de red neuronal profunda, y se entrenan con enormes cantidades de texto para predecir la siguiente pieza de una secuencia. A partir de ese objetivo aparentemente simple emergen capacidades sorprendentes: resumir documentos, traducir, responder preguntas, razonar sobre problemas o escribir programas.
Desde el punto de vista conceptual, un modelo de lenguaje es machine learning en estado puro: un modelo de deep learning entrenado con datos. Lo que ha cambiado es la escala, tanto de los datos como de los modelos, y la forma de utilizarlos. Hoy la mayoría de los desarrolladores no entrenan estos modelos desde cero, sino que los consumen a través de APIs o los ejecutan localmente en versiones abiertas, y los integran en sus aplicaciones:
# Esquema genérico de integración de un modelo de lenguaje mediante una API
import requests

def resumir(texto: str, api_url: str, api_key: str) -> str:
    respuesta = requests.post(
        api_url,
        headers={"Authorization": f"Bearer {api_key}"},
        json={
            "messages": [
                {"role": "user", "content": f"Resume en tres frases:\n\n{texto}"}
            ],
            "max_tokens": 300,
        },
        timeout=30,
    )
    respuesta.raise_for_status()
    return respuesta.json()["content"]
Sobre estos modelos se construyen además los agentes de IA, sistemas que no solo responden, sino que planifican pasos, usan herramientas como buscadores o APIs y ejecutan tareas de varios pasos con cierta autonomía. Curiosamente, los agentes combinan el aprendizaje de los modelos con técnicas clásicas de la IA, como la planificación y la búsqueda, lo que demuestra que la frontera entre ambos mundos sigue siendo relevante.
Diferencias clave entre IA y machine learning
Con todos los conceptos sobre la mesa, podemos resumir las diferencias de forma ordenada.
En cuanto al alcance, la inteligencia artificial es el campo general que persigue que las máquinas se comporten de forma inteligente, mientras que el machine learning es un conjunto de técnicas concretas para lograrlo a partir de datos.
En cuanto al método, la IA puede basarse en reglas escritas por expertos, en búsqueda, en lógica o en aprendizaje. El machine learning siempre se basa en extraer patrones de datos.
En cuanto a la dependencia de datos, un sistema de IA basado en reglas puede funcionar sin un solo dato de entrenamiento. Un sistema de machine learning es inútil sin datos representativos y de calidad.
En cuanto a la adaptación, los sistemas basados en reglas cambian solo cuando alguien los reprograma. Los modelos de machine learning pueden mejorar o adaptarse reentrenándolos con datos nuevos.
En cuanto a la explicabilidad, las reglas explícitas son fáciles de auditar. Muchos modelos de machine learning, especialmente los de deep learning, funcionan como cajas negras cuyas decisiones son difíciles de explicar, lo que plantea retos en sectores regulados.
En cuanto al objetivo de cada sistema concreto, un producto de IA suele perseguir una meta amplia, como ayudar al usuario en tareas cotidianas, mientras que cada modelo de machine learning resuelve una tarea específica y acotada, como predecir si un cliente abandonará un servicio.
Ejemplos reales de cada enfoque
Ver cómo se combinan ambos enfoques en productos conocidos ayuda a fijar las ideas.
Los sistemas de recomendación de las tiendas en línea y las plataformas de vídeo y música son machine learning en estado puro. Aprenden de tu historial de compras, búsquedas y reproducciones, y de los patrones de millones de usuarios similares, para predecir qué te interesará.
Los filtros antispam y antiphishing del correo electrónico combinan modelos de machine learning, entrenados con enormes volúmenes de mensajes, con reglas explícitas y listas de bloqueo mantenidas por expertos en seguridad.
Los asistentes de voz y conversacionales son sistemas de IA compuestos por muchas piezas de machine learning: reconocimiento de voz, comprensión del lenguaje, síntesis de voz y, cada vez más, modelos de lenguaje grandes que generan las respuestas. Algunos asistentes que fueron populares hace pocos años, como Cortana en su forma de asistente personal, han sido retirados o sustituidos por nuevas generaciones basadas en IA generativa.
Los robots industriales usan IA en sentido amplio. Muchos combinan control programado de forma tradicional con modelos de machine learning que detectan anomalías en sensores para anticipar averías, una técnica conocida como mantenimiento predictivo.
Los sistemas de detección de fraude bancario usan modelos supervisados que puntúan cada transacción según su probabilidad de ser fraudulenta, combinados con reglas de negocio que bloquean automáticamente determinados patrones.
Los videojuegos son un caso interesante: la mayoría de los personajes controlados por la máquina siguen usando IA clásica, como máquinas de estados y algoritmos de búsqueda de caminos, porque es predecible, eficiente y fácil de ajustar para los diseñadores.
Cuándo usar machine learning y cuándo no
Una de las consecuencias prácticas de entender la diferencia es saber cuándo tiene sentido recurrir al machine learning y cuándo una solución tradicional es mejor.
El machine learning encaja bien cuando las reglas son demasiado complejas o cambiantes para escribirlas a mano, como reconocer caras o detectar fraude; cuando se dispone de suficientes datos de calidad; y cuando un margen de error es aceptable, porque los modelos son probabilísticos y siempre se equivocan en algún porcentaje de casos.
En cambio, conviene evitarlo cuando las reglas son claras y estables, como calcular impuestos o validar un formulario; cuando no hay datos suficientes o representativos; cuando cada decisión debe ser totalmente explicable y auditable; o cuando un error tiene consecuencias inaceptables y no hay supervisión humana.
Una buena práctica es empezar siempre por una línea base sencilla. Antes de entrenar un modelo complejo, mide qué rendimiento obtiene una regla trivial o un modelo muy simple:
from sklearn.dummy import DummyClassifier

base = DummyClassifier(strategy="most_frequent").fit(X_train, y_train)
print(f"Línea base: {base.score(X_test, y_test):.2%}")
Si tu modelo sofisticado apenas supera esa referencia, probablemente el problema esté en los datos o en el planteamiento, no en el algoritmo.
Errores conceptuales frecuentes
Alrededor de estas tecnologías circulan varias ideas equivocadas que conviene aclarar.
La primera es pensar que IA equivale a una inteligencia general como la humana. Todos los sistemas actuales son estrechos o especializados en mayor o menor medida: incluso los modelos de lenguaje más capaces tienen limitaciones claras y pueden fallar en tareas que a una persona le resultan triviales.
La segunda es creer que un modelo de machine learning “entiende” los datos. Lo que hace es encontrar correlaciones estadísticas. Si los datos de entrenamiento contienen sesgos, por ejemplo históricos en la concesión de créditos o en procesos de selección, el modelo los aprenderá y los reproducirá.
La tercera es asumir que más datos siempre significa mejores resultados. La calidad y la representatividad importan tanto como la cantidad. Un conjunto enorme pero sesgado o lleno de errores produce modelos malos.
La cuarta es confundir un buen resultado en el entrenamiento con un buen modelo. El sobreajuste ocurre cuando el modelo memoriza los datos de entrenamiento en lugar de aprender patrones generales, y su rendimiento cae en picado con datos nuevos. Por eso es imprescindible evaluar siempre con datos que el modelo no ha visto.
La quinta es considerar que un modelo, una vez entrenado, funciona para siempre. El mundo cambia, y los datos también. Un modelo de recomendación entrenado antes de un cambio de hábitos de consumo puede degradarse con el tiempo, un fenómeno conocido como deriva de datos, que obliga a monitorizarlo y reentrenarlo periódicamente.
Cómo empezar a aprender machine learning con Python
Si quieres pasar de la teoría a la práctica, el ecosistema de machine learning con Python es el punto de partida más habitual. Una ruta razonable consiste en:
- Dominar los fundamentos de Python y de librerías como NumPy y pandas para manipular datos.
- Repasar conceptos básicos de estadística, álgebra lineal y probabilidad.
- Practicar con scikit-learn los algoritmos clásicos de clasificación, regresión y agrupamiento.
- Aprender a evaluar modelos correctamente con validación cruzada y métricas adecuadas.
- Pasar al deep learning con PyTorch cuando domines lo anterior.
- Experimentar con modelos de lenguaje a través de APIs y modelos abiertos.
Un entorno de trabajo mínimo se prepara en pocos comandos:
python -m venv .venv
source .venv/bin/activate
pip install numpy pandas scikit-learn matplotlib jupyter
jupyter lab
Los conjuntos de datos públicos, como los incluidos en scikit-learn o los de plataformas de competiciones de ciencia de datos, permiten practicar con problemas reales sin necesidad de recopilar datos propios.
Conclusiones
La inteligencia artificial y el machine learning no son sinónimos, sino conceptos anidados. La inteligencia artificial es el campo amplio que busca que las máquinas realicen tareas que asociamos con la inteligencia humana, y puede lograrlo mediante reglas, búsqueda, lógica o aprendizaje. El machine learning es el subconjunto de técnicas que consiguen ese objetivo aprendiendo patrones a partir de datos, sin que nadie programe explícitamente las reglas.
Dentro del machine learning, el aprendizaje supervisado, el no supervisado y el aprendizaje por refuerzo resuelven tipos de problemas distintos, y el deep learning, basado en redes neuronales profundas, ha permitido avances espectaculares en visión, voz y lenguaje. La IA generativa y los modelos de lenguaje grandes son la expresión más reciente de esa evolución, y los agentes que se construyen sobre ellos vuelven a combinar el aprendizaje con técnicas clásicas de planificación.
Entender estas diferencias tiene consecuencias muy prácticas. Permite interpretar con criterio las afirmaciones comerciales sobre productos “con IA”, elegir el enfoque adecuado para cada problema, saber cuándo una regla sencilla es mejor que un modelo y anticipar los riesgos asociados a los datos, como los sesgos, el sobreajuste o la deriva.
La mejor forma de interiorizar estos conceptos es experimentar. Con Python, scikit-learn y unos pocos conjuntos de datos públicos puedes entrenar tus primeros modelos en una tarde y ver por ti mismo cómo una máquina aprende a partir de ejemplos.