El día que el autor de Clean Code dijo que ya no leía el código
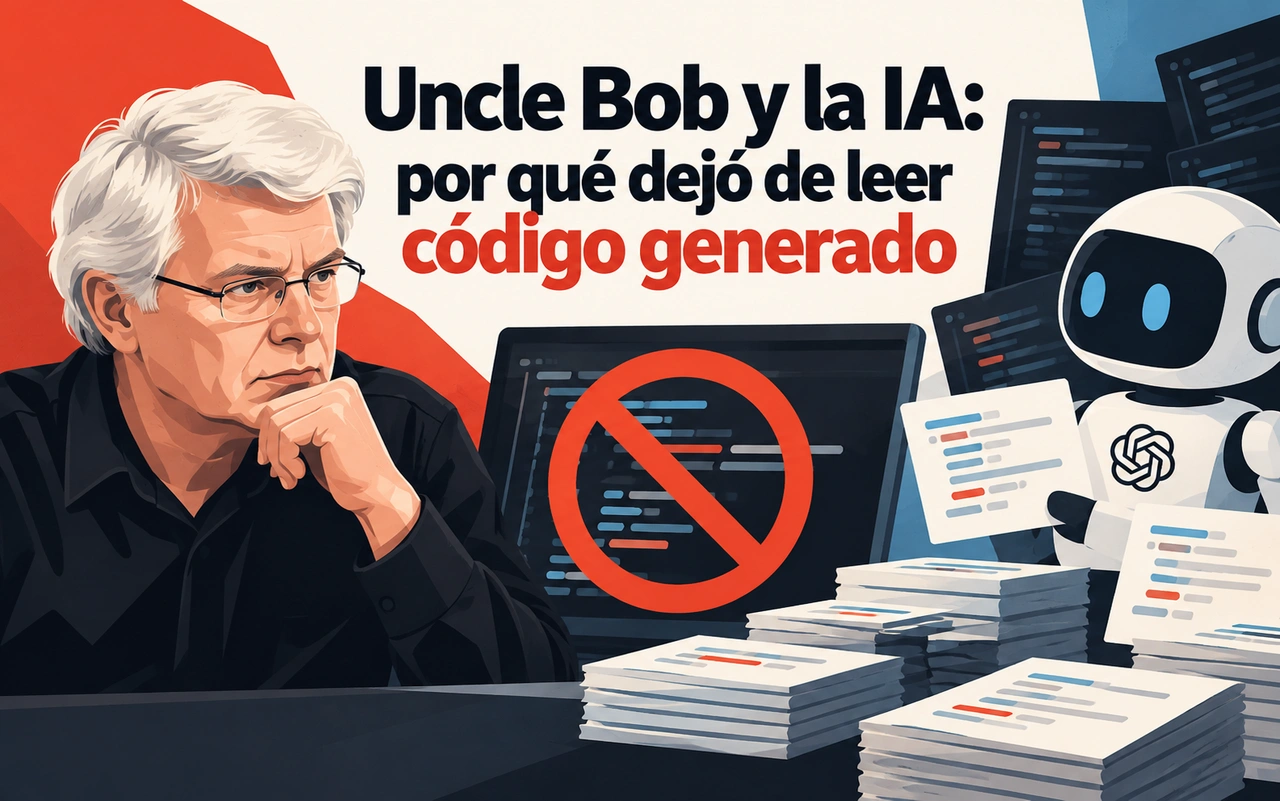
El 23 de julio de 2026, Robert C. Martin, conocido mundialmente como Uncle Bob, publicó un mensaje que parecía contradecir buena parte de la filosofía que había defendido durante décadas.
El autor de Clean Code, uno de los libros más influyentes sobre buenas prácticas de programación, afirmó que su estrategia actual consistía en no leer el código escrito por sus agentes de inteligencia artificial.
La declaración provocó una discusión inmediata.
Durante años, Martin había insistido en que el código debía ser comprensible, mantenible y cuidadosamente estructurado. Sus ideas habían influido en generaciones de desarrolladores, equipos de ingeniería y empresas de software.
Ahora parecía defender exactamente lo contrario.
Si uno de los principales promotores del código limpio había decidido dejar de leer lo que producía la inteligencia artificial, ¿significaba que la revisión humana había dejado de ser necesaria?
La respuesta estaba en el resto de su mensaje.
Martin explicó que no confiaba ciegamente en los agentes. En lugar de revisar cada línea, sometía su trabajo a un conjunto de restricciones, pruebas automatizadas, métricas y procedimientos de verificación.
Su propuesta no consistía en abandonar la ingeniería de software, sino en cambiar el punto donde se aplicaba el criterio humano.
El programador dejaba de supervisar continuamente la implementación y concentraba una mayor parte de su atención en las especificaciones, los criterios de aceptación y los mecanismos utilizados para comprobar los resultados.
La controversia surgió porque la frase más llamativa era también la más fácil de sacar de contexto.
Para comprender lo que realmente proponía Uncle Bob, es necesario regresar a una época en la que los agentes de inteligencia artificial no existían y la programación comenzaba a convertirse en una disciplina profesional.
Robert C. Martin y sus primeros años como programador
Robert Cecil Martin comenzó a programar a finales de la década de 1960.
En aquella época, el desarrollo de software era muy diferente al actual.
Los equipos informáticos eran costosos, los recursos de procesamiento estaban limitados y muchas herramientas que hoy se consideran indispensables todavía no existían.
Los programadores trabajaban con lenguajes, sistemas operativos y procedimientos de desarrollo que exigían comprender cuidadosamente las limitaciones de las máquinas.
La industria también comenzaba a enfrentarse a un problema que acompañaría al software durante décadas: los programas podían funcionar correctamente durante sus primeras versiones y convertirse después en sistemas difíciles de modificar.
A medida que aumentaba su tamaño, también crecían las dependencias entre componentes.
Una modificación aparentemente sencilla podía provocar errores inesperados en otras partes de la aplicación.
Martin desarrolló su carrera dentro de ese contexto.
Con el paso de los años se convirtió en una figura reconocida por sus aportaciones a las prácticas de diseño, pruebas y organización del software.
Su trabajo estuvo relacionado con el movimiento de desarrollo ágil y con la difusión de principios destinados a mejorar la calidad de los programas.
En 2001 participó entre los firmantes del Manifiesto por el Desarrollo Ágil de Software.
También contribuyó a popularizar los principios SOLID, utilizados para explicar distintas prácticas de diseño orientado a objetos.
Su influencia aumentó considerablemente en 2008 con la publicación de Clean Code: A Handbook of Agile Software Craftsmanship.
El libro defendía una idea fundamental: escribir código que funciona no es suficiente.
También debe ser posible comprenderlo, modificarlo y mantenerlo.
Aquella filosofía parecía difícil de reconciliar con la decisión de dejar que una inteligencia artificial escribiera código sin revisarlo línea por línea.
Pero la contradicción era menos evidente de lo que parecía.
Clean Code y la importancia de comprender el software
Clean Code apareció en un momento en el que las aplicaciones empresariales crecían rápidamente y los equipos necesitaban mantener sistemas durante periodos cada vez más largos.
Martin defendía que el código debía expresar claramente su intención.
Los nombres de variables y funciones debían comunicar su propósito.
Las responsabilidades tenían que estar organizadas de manera comprensible.
Las dependencias innecesarias debían reducirse.
Y las pruebas debían permitir modificar el sistema sin introducir errores inesperados.
El objetivo no era conseguir programas visualmente elegantes.
Era reducir el costo de comprender y modificar el software.
Una aplicación puede funcionar correctamente y, sin embargo, resultar extraordinariamente difícil de mantener.
Los problemas aparecen cuando sus componentes están demasiado acoplados, las responsabilidades se mezclan o las decisiones importantes permanecen ocultas dentro de implementaciones complejas.
En esos escenarios, cada cambio exige investigar grandes cantidades de código.
Martin consideraba que la disciplina técnica podía reducir ese problema.
Su propuesta también estaba relacionada con una idea más amplia: la responsabilidad profesional del desarrollador.
Un programador no debería limitarse a producir instrucciones que una computadora pueda ejecutar.
También debería comprender los efectos de sus decisiones y contar con mecanismos para detectar errores.
Durante décadas, esa responsabilidad estuvo estrechamente relacionada con leer, escribir y revisar código.
La llegada de los agentes de inteligencia artificial introdujo una nueva posibilidad.
¿Qué ocurriría si el desarrollador pudiera especificar lo que necesita, establecer restricciones verificables y delegar la implementación?
La pregunta no eliminaba los principios de Clean Code.
Los trasladaba a un proceso donde una parte importante del trabajo podía ser realizada por software.
El desarrollo guiado por pruebas antes de la inteligencia artificial
Una de las claves para comprender la posición de Martin se encuentra en una práctica anterior al auge de los modelos de lenguaje.
Se trata del desarrollo guiado por pruebas, conocido como Test-Driven Development o TDD.
La técnica se popularizó especialmente mediante el trabajo de Kent Beck y el movimiento Extreme Programming.
Su principio consiste en definir primero una prueba que describa un comportamiento esperado.
Inicialmente, la prueba falla porque la funcionalidad todavía no existe.
Después, el desarrollador implementa el comportamiento necesario para que la prueba se supere.
Finalmente, mejora la estructura del código sin modificar su comportamiento observable.
Este ciclo suele resumirse mediante tres etapas: rojo, verde y refactorización.
La importancia histórica del enfoque está en que cambia el orden habitual del desarrollo.
En lugar de escribir una implementación completa y comprobar posteriormente si funciona, el programador establece primero una expectativa verificable.
La prueba se convierte en una expresión concreta de lo que el sistema debe hacer.
Esto no significa que TDD garantice automáticamente software correcto.
Una prueba puede contener errores.
También puede comprobar un comportamiento equivocado o ignorar situaciones importantes.
Sin embargo, el enfoque introduce una disciplina: antes de implementar, es necesario definir cómo se reconocerá el éxito.
Con los agentes de inteligencia artificial, esa idea adquiere una dimensión diferente.
Ahora es posible delegar tanto la generación del código como parte de la creación y ejecución de las pruebas.
El problema deja de ser exclusivamente cómo escribir una función.
También consiste en determinar qué restricciones permitirán confiar en el resultado.
El auge de los agentes que escriben software
Durante los primeros años de la inteligencia artificial generativa aplicada a programación, muchas herramientas funcionaban principalmente como asistentes.
Un desarrollador escribía una instrucción y recibía una sugerencia de código.
Después debía decidir si aceptarla, modificarla o descartarla.
La supervisión humana permanecía cerca de cada cambio.
Pero las capacidades de las herramientas evolucionaron.
Los agentes comenzaron a trabajar con repositorios completos, consultar archivos, ejecutar comandos, modificar varios componentes y realizar pruebas.
También podían utilizar los resultados de esas pruebas para corregir sus propios errores.
El proceso ya no consistía únicamente en generar fragmentos aislados.
Un agente podía recibir un objetivo, identificar los archivos relevantes, implementar una solución y comprobar si el proyecto seguía funcionando.
Este cambio planteó un problema de escala.
Si una herramienta produce unas pocas líneas, revisarlas resulta relativamente sencillo.
Si modifica decenas de archivos en pocos minutos, la lectura humana puede convertirse en el principal cuello de botella.
La situación se complica cuando varios agentes trabajan simultáneamente.
El tiempo necesario para generar código puede reducirse considerablemente, pero el esfuerzo requerido para comprenderlo y revisarlo no desaparece.
En algunos casos, incluso aumenta.
Martin comenzó a experimentar con una respuesta diferente.
En lugar de intentar leer cada modificación producida por sus agentes, buscó construir mecanismos que permitieran evaluar el resultado mediante especificaciones y pruebas.
El cambio trasladaba la atención desde la producción del código hacia su verificación.
El mensaje de Ori Pomerantz que inició la discusión
La declaración de Uncle Bob no apareció como un manifiesto independiente.
Fue una respuesta a otro programador.
El 22 de julio de 2026, Ori Pomerantz publicó una reflexión sobre su experiencia utilizando Claude para escribir software.
Pomerantz explicó que no se sentía completamente cómodo permitiendo que una inteligencia artificial modificara sus archivos.
Su preocupación estaba relacionada con la responsabilidad.
Si debía responder por el funcionamiento del código, sentía la necesidad de comprenderlo.
También mencionó que había comenzado a programar en 1983 y se preguntó si esa incomodidad reflejaba una manera anticuada de trabajar.
Al día siguiente, Robert C. Martin respondió.
Señaló que era considerablemente mayor y que había comenzado a programar a finales de los años sesenta.
Después describió su estrategia.
No leía habitualmente el código producido por sus agentes porque consideraba que hacerlo limitaba la productividad que podía obtener de ellos.
Pero inmediatamente explicó qué utilizaba en su lugar.
Mencionó pruebas unitarias, pruebas de aceptación escritas con Gherkin, procedimientos de aseguramiento de calidad, métricas, cobertura y mutation testing.
Su confianza no procedía de asumir que los agentes eran infalibles.
Procedía de someter su trabajo a un conjunto exigente de verificaciones.
El mensaje se difundió ampliamente porque parecía representar un cambio radical en la filosofía de uno de los programadores más conocidos de la industria.
Sin embargo, la controversia también demostró cómo una frase puede adquirir un significado distinto cuando se separa de su explicación.
Lo que realmente significaba dejar de leer el código
La afirmación de Martin no debe interpretarse como una recomendación universal de aceptar cualquier modificación generada por inteligencia artificial.
Su estrategia dependía de contar con un sistema de restricciones.
Antes de delegar la implementación, necesitaba definir qué comportamiento debía producir el software.
También debía establecer cómo comprobar que ese comportamiento se cumplía.
El agente podía escribir código, pero el resultado tenía que superar diferentes mecanismos de evaluación.
Las pruebas unitarias comprobaban comportamientos específicos.
Las pruebas de aceptación verificaban escenarios relacionados con los requisitos.
Las métricas permitían identificar determinados problemas de complejidad y estructura.
Las pruebas de mutación ayudaban a evaluar si la batería de pruebas era suficientemente sensible para detectar errores.
Los procedimientos de calidad añadían verificaciones complementarias.
El objetivo era reducir la dependencia de una inspección humana exhaustiva de cada línea.
Sin embargo, existe una diferencia importante entre no realizar una revisión línea por línea de toda la implementación y no inspeccionar nunca ningún fragmento de código.
En otras publicaciones de 2026, Martin describió revisiones selectivas de especificaciones, pruebas y código.
También explicó que supervisaba determinadas decisiones arquitectónicas.
Por tanto, su postura debe entenderse como una reducción deliberada de la revisión manual detallada, no como la eliminación absoluta de toda intervención humana.
La verificación del código generado por IA se convertía en el centro de su método.
El desarrollador debía invertir más esfuerzo en diseñar mecanismos confiables para evaluar resultados y menos en seguir personalmente cada paso de implementación.
Las pruebas unitarias como primera barrera
Las pruebas unitarias constituyen una de las herramientas más conocidas para verificar software.
Su propósito es comprobar el comportamiento de unidades relativamente pequeñas, como funciones, clases o componentes.
Una prueba puede establecer que determinada operación devuelve un resultado esperado cuando recibe valores concretos.
También puede comprobar cómo responde el sistema ante entradas inválidas o situaciones excepcionales.
En el desarrollo asistido por inteligencia artificial, estas pruebas permiten proporcionar retroalimentación rápida.
Un agente puede implementar una funcionalidad, ejecutar la batería de pruebas y detectar que alguno de los comportamientos esperados no se cumple.
Después puede modificar la implementación e intentarlo nuevamente.
Este ciclo reduce la necesidad de que una persona identifique manualmente cada error funcional.
Pero las pruebas unitarias tienen límites.
Una batería puede comprobar correctamente componentes individuales y no detectar problemas de integración.
También puede ignorar comportamientos importantes que nunca fueron incluidos en las especificaciones.
Además, existe un riesgo cuando el mismo agente genera tanto el código como sus pruebas.
Si interpreta incorrectamente un requisito, puede producir una implementación equivocada acompañada de pruebas que confirman ese mismo error.
Todos los resultados aparecerían como correctos, aunque el software no resolviera el problema original.
Por eso Martin no se limitaba a utilizar pruebas unitarias.
Su propuesta incluía mecanismos adicionales destinados a verificar el comportamiento desde perspectivas diferentes.
Gherkin y la importancia de especificar comportamientos
Gherkin es un lenguaje utilizado para describir comportamientos de software mediante escenarios legibles.
Su estructura suele organizarse alrededor de condiciones iniciales, acciones y resultados esperados.
La principal ventaja consiste en separar la descripción de un comportamiento de los detalles técnicos utilizados para implementarlo.
Una especificación puede establecer qué debería ocurrir cuando un usuario realiza determinada acción, sin indicar exactamente qué clases, funciones o estructuras de datos deben utilizarse.
Esto facilita discutir requisitos desde una perspectiva más cercana al comportamiento del producto.
Para Martin, las especificaciones escritas en Gherkin se convirtieron en una parte importante de sus experimentos con agentes.
El desarrollador podía definir escenarios que representaran las expectativas del sistema.
Después, los agentes podían generar implementaciones destinadas a satisfacer esas condiciones.
La diferencia respecto a una instrucción informal es que los escenarios pueden transformarse en verificaciones ejecutables.
Pero su valor depende de la calidad de las especificaciones.
Un escenario ambiguo puede permitir diferentes interpretaciones.
Uno incompleto puede dejar fuera situaciones relevantes.
Y uno incorrecto puede hacer que el agente construya exactamente el comportamiento equivocado.
Por eso el papel humano continúa siendo importante.
El desarrollador necesita comprender el problema que intenta resolver y decidir qué resultados constituyen una implementación aceptable.
La inteligencia artificial puede ayudar a transformar requisitos en pruebas, pero no puede garantizar por sí sola que las expectativas originales representen correctamente las necesidades del negocio.
Mutation testing: comprobar si las pruebas realmente detectan errores
Una de las técnicas más interesantes mencionadas por Martin es el mutation testing.
Su propósito no consiste simplemente en comprobar que las pruebas existentes se ejecutan correctamente.
Busca evaluar si esas pruebas son capaces de detectar cambios incorrectos en el programa.
Para hacerlo, una herramienta introduce modificaciones controladas en el código.
Puede alterar una condición, cambiar un operador o modificar una expresión.
Después ejecuta las pruebas.
Si alguna prueba falla debido al cambio, se considera que la mutación fue detectada.
Si todas continúan funcionando, puede existir una debilidad en la batería de pruebas.
El razonamiento es importante.
Una prueba que siempre pasa no necesariamente demuestra que el software esté bien protegido contra errores.
También puede significar que la prueba no está comprobando suficientemente el comportamiento relevante.
El mutation testing introduce errores deliberados para observar si las verificaciones reaccionan.
Sin embargo, tampoco constituye una garantía absoluta.
Algunas mutaciones pueden producir comportamientos equivalentes al código original.
Otras pueden afectar situaciones difíciles de ejecutar.
Además, obtener una puntuación elevada no significa que todos los requisitos del sistema sean correctos.
La técnica evalúa principalmente la capacidad de determinadas pruebas para detectar cambios en la implementación.
Martin también experimentó con una variante relacionada con las pruebas de aceptación.
En lugar de modificar únicamente el código de producción, propuso alterar valores utilizados dentro de escenarios Gherkin.
La finalidad era comprobar que las pruebas de aceptación estuvieran realmente conectadas con el comportamiento de la aplicación.
Esta distinción es importante porque permite detectar otro problema: pruebas que parecen correctas, pero que no ejercitan adecuadamente el sistema real.
Las métricas que complementan las pruebas funcionales
Un programa puede superar todas sus pruebas y continuar presentando problemas de diseño.
Puede contener funciones demasiado complejas, dependencias difíciles de mantener o componentes con responsabilidades excesivas.
Por eso Martin también mencionó métricas de calidad.
Entre las medidas que ha utilizado se encuentran la complejidad ciclomática, la cobertura de pruebas y determinadas características estructurales del código.
La complejidad ciclomática intenta cuantificar los caminos de ejecución presentes en una unidad de software.
Un valor elevado puede indicar que existen demasiadas decisiones y que el componente resulta difícil de comprender o verificar.
La cobertura muestra qué partes del código fueron ejecutadas durante las pruebas.
Sin embargo, ejecutar una línea no significa necesariamente comprobar correctamente su comportamiento.
También existen métricas que combinan complejidad y cobertura para identificar componentes con mayor riesgo de resultar difíciles de mantener.
Una de ellas es CRAP, abreviatura de Change Risk Anti-Patterns.
Estas herramientas permiten establecer restricciones cuantificables.
Un agente puede recibir instrucciones para reducir complejidad, eliminar duplicaciones o mejorar determinadas características estructurales antes de considerar terminada una tarea.
Pero las métricas no sustituyen completamente el criterio profesional.
Una función puede cumplir los límites establecidos y seguir utilizando una abstracción incorrecta.
Una arquitectura puede tener indicadores aceptables y resultar inadecuada para las necesidades futuras del sistema.
Las métricas ayudan a identificar riesgos.
No demuestran por sí solas que el diseño sea óptimo.
El sistema de agentes que Martin describió durante 2026
La publicación viral de julio no fue el comienzo de los experimentos de Martin.
Durante los meses anteriores ya había descrito diferentes formas de organizar agentes especializados.
En marzo de 2026 explicó su interés por utilizar Gherkin como mecanismo principal para especificar comportamientos.
En abril habló sobre la posibilidad de reducir la revisión manual del código y utilizar métricas y pruebas como mecanismos de control.
Durante mayo continuó experimentando con pruebas de mutación aplicadas a escenarios de aceptación.
El 1 de junio describió una organización en la que distintos agentes asumían responsabilidades especializadas.
Algunos ayudaban a transformar requisitos informales en especificaciones más precisas.
Otros generaban pruebas y código.
También utilizaba agentes para refactorización y evaluación arquitectónica.
La participación humana se concentraba especialmente en las especificaciones y en revisiones selectivas.
No se trataba de un proceso completamente autónomo.
Martin seguía tomando decisiones sobre el comportamiento esperado y supervisando determinados resultados.
Además, el sistema evolucionó con el tiempo.
En julio reconoció que aplicar todas las capas de verificación a cualquier proyecto podía resultar innecesario.
Algunas tareas podían requerir únicamente pruebas unitarias y métricas básicas.
Los proyectos más complejos podían justificar verificaciones adicionales.
En septiembre, al explicar sus experiencias con agentes, describió un enfoque más sencillo que algunas de sus primeras configuraciones de múltiples agentes.
Conservó el énfasis en pruebas, restricciones y supervisión, pero dejó de tratar una organización especialmente compleja de agentes como un requisito universal.
Esta evolución muestra que su método no era una receta definitiva.
Era una práctica experimental que continuaba ajustando.
La diferencia entre productividad y confianza
Una de las razones por las que los agentes resultan atractivos es su capacidad para producir modificaciones rápidamente.
Pueden localizar archivos, generar implementaciones y ejecutar herramientas en tiempos reducidos.
Sin embargo, la velocidad de producción no equivale necesariamente a productividad real.
Si un agente genera una gran cantidad de código que posteriormente requiere horas de depuración, el ahorro inicial puede desaparecer.
Lo mismo ocurre cuando una implementación supera pruebas superficiales, pero introduce errores difíciles de detectar.
La productividad depende del tiempo necesario para obtener un resultado correcto y mantenible.
Martin intentó abordar ese problema mediante verificaciones automatizadas.
En lugar de medir únicamente cuánto código podía producir un agente, buscaba determinar si ese código cumplía restricciones previamente establecidas.
El enfoque también introduce costos.
Ejecutar numerosas pruebas, analizar métricas y realizar mutation testing puede consumir recursos de procesamiento y aumentar el tiempo de ejecución.
Por eso no siempre resulta conveniente utilizar el conjunto más extenso de verificaciones.
La decisión depende de la complejidad del proyecto, los riesgos y el costo de detectar un error después de entregar el software.
Un prototipo experimental no necesita necesariamente los mismos controles que un sistema financiero utilizado por miles de personas.
La enseñanza no consiste en maximizar indiscriminadamente la cantidad de pruebas.
Consiste en diseñar verificaciones proporcionales a los riesgos.
Los problemas que una batería de pruebas puede pasar por alto
La propuesta de Martin también recibió críticas.
Una de las objeciones más importantes consiste en que las pruebas automatizadas no pueden demostrar todas las propiedades relevantes de un sistema.
Un programa puede cumplir sus requisitos funcionales y, sin embargo, contener vulnerabilidades de seguridad.
También puede presentar problemas de rendimiento que solo aparecen bajo determinadas condiciones de carga.
Una implementación puede funcionar correctamente, pero resultar innecesariamente compleja.
Incluso puede satisfacer todas las pruebas disponibles mientras introduce dependencias arquitectónicas que dificultarán futuras modificaciones.
Grady Booch, una figura influyente en la ingeniería de software y el desarrollo de UML, participó en discusiones sobre los límites de sustituir la inspección humana por métricas y pruebas.
Las preocupaciones giraban alrededor de problemas que no siempre se manifiestan como fallos funcionales.
Entre ellos se encuentran decisiones arquitectónicas deficientes, vulnerabilidades y oportunidades de refactorización que las pruebas convencionales pueden no detectar.
La crítica plantea una cuestión fundamental.
Si un sistema automatizado solo verifica aquello que fue especificado, ¿qué sucede con los problemas que nadie anticipó?
Las pruebas pueden detectar desviaciones respecto a expectativas conocidas.
Pero no garantizan descubrir todos los riesgos desconocidos.
Por eso la revisión arquitectónica, el análisis de seguridad y la evaluación del comportamiento real siguen siendo relevantes.
El desafío consiste en determinar cuáles de esas actividades pueden automatizarse con confianza y cuáles requieren intervención humana especializada.
El riesgo de que la IA escriba el código y también las pruebas
Cuando una persona escribe código y otra lo revisa, existe cierta separación entre quien implementa y quien evalúa.
Esa separación no garantiza que se detecten todos los errores, pero introduce una oportunidad para identificar supuestos equivocados.
Con los agentes de inteligencia artificial puede ocurrir algo diferente.
El mismo sistema puede interpretar un requisito, generar código, escribir pruebas y concluir que el resultado es correcto.
Si todas esas actividades comparten una interpretación equivocada, las verificaciones pueden confirmar el error.
Por ejemplo, una especificación podría omitir una condición importante relacionada con permisos de usuario.
El agente implementaría el comportamiento descrito.
Después escribiría pruebas que comprobaran exactamente ese comportamiento.
Todas podrían superarse.
Pero el sistema continuaría siendo inseguro porque el requisito original estaba incompleto.
El problema no estaría necesariamente en la implementación.
Estaría en la definición de lo que debía comprobarse.
Este riesgo explica por qué Martin concede tanta importancia a las especificaciones.
También muestra que no basta con multiplicar agentes.
Varios agentes que utilizan los mismos supuestos pueden reproducir errores similares.
La independencia de las verificaciones importa tanto como su cantidad.
Una arquitectura de evaluación confiable necesita considerar diferentes perspectivas y evitar que todos los mecanismos dependan de una única interpretación.
Qué cambió realmente en la filosofía de Uncle Bob
La declaración de julio de 2026 parecía anunciar el abandono de una disciplina que Martin había defendido durante décadas.
Pero su evolución puede interpretarse de otra manera.
Clean Code surgió en una época en la que los desarrolladores humanos escribían directamente la mayor parte de las implementaciones.
La legibilidad del código facilitaba comprender, modificar y mantener los sistemas.
Con la inteligencia artificial, Martin comenzó a experimentar con un proceso donde los humanos podían dedicar más atención a definir resultados y restricciones.
Los agentes asumían una mayor proporción de la implementación.
Las pruebas y métricas proporcionaban evidencia sobre el comportamiento del software.
Esto no elimina la necesidad de mantener código comprensible.
Incluso cuando una persona no revisa cada línea, una estructura clara puede facilitar el diagnóstico de errores, la evolución del producto y el trabajo de otros desarrolladores.
Tampoco significa que el programador deje de ser responsable.
La responsabilidad se desplaza hacia la definición del problema, la selección de restricciones y la evaluación de resultados.
El cambio resulta especialmente significativo porque proviene de alguien cuya carrera comenzó antes de que existieran muchas de las herramientas modernas de desarrollo.
Martin no abandonó las prácticas de ingeniería que había promovido.
Intentó adaptarlas a una forma de producción en la que escribir instrucciones ya no era necesariamente la actividad más costosa.
El papel del desarrollador cuando los agentes producen la implementación
La evolución de los agentes introduce una pregunta importante para la profesión.
Si la inteligencia artificial puede producir gran parte del código, ¿qué habilidades conservarán mayor importancia?
La experiencia de Martin sugiere que definir problemas correctamente puede adquirir todavía más valor.
También resulta fundamental comprender cómo se comportan los sistemas, identificar riesgos y diseñar mecanismos de evaluación.
La arquitectura continúa siendo relevante porque las decisiones estructurales afectan la evolución del software.
La seguridad también exige conocimientos especializados que no pueden reducirse a comprobar si las pruebas funcionales se ejecutan correctamente.
Además, los desarrolladores necesitan comprender las limitaciones de las herramientas que utilizan.
Un agente puede generar soluciones plausibles que contienen errores.
Puede interpretar incorrectamente requisitos ambiguos.
También puede modificar componentes que no debería tocar o introducir dependencias innecesarias.
La automatización no elimina estos riesgos.
Modifica la manera en que aparecen.
Por eso la ingeniería de software con agentes de IA requiere combinar conocimientos tradicionales con nuevas prácticas de supervisión.
Los profesionales que comprendan arquitectura, pruebas, seguridad y comportamiento de sistemas tendrán mejores herramientas para evaluar el trabajo automatizado.
La capacidad de producir código rápidamente seguirá siendo útil.
Pero no será suficiente para garantizar resultados confiables.
Conclusiones
La declaración de Robert C. Martin en julio de 2026 provocó una controversia porque parecía contradecir su trayectoria como defensor del código limpio.
El autor de Clean Code afirmó que había dejado de leer habitualmente el código producido por sus agentes de inteligencia artificial.
Sin embargo, el mensaje completo describía una estrategia más exigente que la simple aceptación de resultados automatizados.
Martin utilizaba pruebas unitarias, especificaciones de aceptación, métricas, mutation testing y otros mecanismos destinados a verificar el comportamiento y la calidad del software.
Su enfoque también incluía intervención humana en la definición de requisitos y revisiones selectivas.
La diferencia era que intentaba evitar que la inspección línea por línea se convirtiera en el principal límite de productividad.
La idea tenía antecedentes claros en el desarrollo guiado por pruebas y en décadas de prácticas de ingeniería de software.
Lo novedoso era aplicarla a sistemas capaces de generar implementaciones y ejecutar verificaciones de manera autónoma.
Pero la propuesta conserva limitaciones importantes.
Las pruebas pueden ser incompletas, las especificaciones pueden estar equivocadas y determinadas vulnerabilidades o problemas arquitectónicos pueden escapar a las métricas automatizadas.
Además, un sistema que genera tanto el código como sus propias pruebas puede confirmar errores derivados de una interpretación incorrecta.
Por eso la conclusión no es que todos los desarrolladores deban dejar de revisar código generado por inteligencia artificial.
La verdadera transformación consiste en comprender que la responsabilidad profesional puede ejercerse mediante diferentes mecanismos de supervisión.
En algunos proyectos, la revisión manual detallada continuará siendo indispensable.
En otros, un conjunto sólido de especificaciones, pruebas y controles automatizados permitirá delegar una mayor parte de la implementación.
La historia de Uncle Bob muestra que las herramientas pueden cambiar radicalmente sin eliminar los principios fundamentales de la ingeniería de software.
El objetivo continúa siendo construir sistemas correctos, seguros y mantenibles.
Lo que está cambiando es la manera de demostrar que realmente lo son.